Home

 Creators
 Search
 Recent
 Random
 Posts
 DMs
 Tags
 Random
 Importer
 Import
 FAQ
 Account
 Register
 Login
 Favorites
 Keys
 Logout
 Telegram

SDXL & illustriousが理解る!ライセンスから操作法、人気モデルの扱いまで (Pixiv Fanbox)
Content
こんばんは、スタジオ真榊です。この記事は、ローカル画像生成で2025年現在主流となっているSDXL系モデルについての特集です。そもそもSDXLとは何なのか、ライセンスの読み方やファインチューン、illustrious系を始めとした人気派生モデルの特徴などについて、幅広く解説しています。
以前はSDXLの入門モデルと言えば「AnimagineXLv3.0」でしたが、現在コミュニティ内で主流となっているのはillustrious系。こちらの記事(▼)のアップデート版という位置付けで、SDXLを触る上で押さえておくべき基本知識を網羅しています。
目次
SDXL(StableDiffusionXL)とは
・NovelAIv3に採用▶「Animagine」でヒット
SDXL利用に必要なグラボは?
SDXLのライセンス
・CreativeML Open RAIL++-Mの概要
・ライセンスとは別に「利用規約」もある
SDXLモデルの「ファインチューン」
・出汁に味噌を入れて味噌汁にする
illustriousとは?
・黒をより黒く!新訓練法「VPred」
・ライセンスは「FAIPL」
・自然言語プロンプトをサポート
・illustrious系の人気派生モデルは?
・WAI-NSFW-illustrious-SDXLについて
SDXLでローカル環境入門
・ローカル環境を「StablityMatrix」で構築
・WAI-NSFW-illustrious-SDXLで生成してみよう
版権キャラクター再現と著作権
SDXL向け画像生成サイズ
サンプラー選びについて
SDXL系のControlnet
・Noobai系CNモデル
「自分画風」のファインチューン
終わりに
SDXL(StableDiffusionXL)とは
2023年7月にデビューした「SDXL(StableDiffusionXL)1.0」は、英StabilityAI社が提供するtext to imageモデルです。「illustriousXL」や「AnimagineXL」「pony diffusion」など、人気派生モデルとそれらのマージモデルが充実しており、記事執筆現在、Civitaiなどのプラットフォーム上で流通しているLoRAやControlnetの多くはSDXL向けとなっています。
2022年にデビューし、最初にローカル用として普及した「StableDiffusion1.5(SD1.5)」系列のモデルは512x512pxでの生成が基本で、当時の画像生成と言えば「小さく出して大きくアップスケールする」のが常識でした。これに対し、SDXLではいきなり1024pxクラスの高画質で生成しても、人体が奇形化したり、背景がおかしくなったりしなくなったのが最大の特徴。今では当たり前の生成サイズですが、当時としては「大きいサイズ」を意味する"XL"だったわけですね。
ライセンスも使いやすい内容だったことから、多くの派生モデルやLoRAなどがSDXLをベースとして作成・共有されました。StabilityAI社からはその後、後発モデルであるSD3やSD3.5などがリリースされていますが、SDXLはレビューから2年以上経過した現在も、ローカル画像生成の主流ベースモデルとして幅広く支持されています。
弱点としては、前景(キャラクター)の生成に優れている一方、背景の生成はやや苦手なところでしょうか。指などの生成もかなり安定するようになりましたが、6本指など破綻した画像が出たり、キャラクターが分裂してしまったりする不具合は残っています。SD3.5やFluxといった後発モデルはこうした部分を克服しているのですが、派生モデルやLoRAの豊富さ、ローカルでの取り回しの良さなどを考えると、やはりLoRAなどが充実しているSDXLのほうに軍配が上がったということです。
・NovelAIv3に採用▶「Animagine」でヒット
ベースモデルが異なると、LoRAやControlnetといった周辺技術が利かなくなるため、デビューしてすぐにSDXLが支持されたわけではありませんでした。転機となったのが、SDXLベースで初めてトレーニングされたNovelAI「v3」の登場です。当時としては驚異的な精度でアニメ調イラストを生成できるようになり、インペイントなども高品質にできたことから、SDXLの高機能ぶりを知らしめることになりました。
そして、SD1.5系からの「移住」が起こる直接のきっかけになったのは、人気アニメ調モデル「AnimagineXL3.0」(アニマジン系)の流行でした。NovelAIv3と同様、幅広い版権キャラクターの再現ができ、NSFW生成も得意だったことから、これをきっかけにローカル環境をSDXL向けに一新したユーザーが多かったように思います。
その後、SDXLベースの派生モデルではNSFW生成に優れた「pony diffusion」系が一世を風靡しました。pony diffusionはいまも愛好者が多いのですが、プロンプトを打つときにdanbooru語だけでなく「e621語」の理解も必要なため、少しクセが強いモデルとなっています。(詳しくは下記記事参照)
2025年夏現在は、さらにその次世代として流行した韓国AI企業発の「illustrious(イラストリアス)」系が主流となっています。この記事では、このillustrious系でローカル画像生成を始める方を想定して、必要な知識を紹介していきます。
SDXL利用に必要なグラボは?
さて、ローカル環境で画像生成を行うには、それなりに高性能なNVIDIA製グラフィックボードが必要となります。搭載しているVRAMの容量は最低8GB、できれば12GB以上のものがないと、GPUに負担のかかる高画質な画像生成や複数同時生成が難しくなります。特にローカル環境ならではと言える追加学習を自前で行う場合、最低VRAM12GB以上、できれば16GB以上を搭載したグラボがほしいところです。
▲スタジオ真榊で利用しているRTX4080はVRAM16GB。(購入記)
SDXL生成においては「VRAM12GBが快適利用できる最低ライン」「できれば16GBほしい」「24GBから万全」というのがリアルなところでしょう。VRAM8GB以下で頑張っているユーザーも少なくないと思いますが、LoRA学習や動画生成に時間がかかりすぎたり、大きいサイズで生成できなかったりする場面が増えると思いますので、画像生成のためにグラボを新規購入するなら12GB~が絶対おすすめ。
スタジオ真榊では激安10万円で譲っていただいたRTX4080(VRAM16GB)を使用していますが、普段作品作りやLoRA学習、動画生成を楽しむ上で十分なスペックを感じています。もちろん上を見れば限りないわけですが、時間のかかる作業は外出中や就寝中に行うことが多いので、16GBで不便を感じるのは24GBの世界を体験した者だけだと思います。
StableDiffusionにおける各グラボの生成速度については、「ちもろぐ」さんの記事が参考になります(2024年4月の記事)。一昔前だと、入門ならRTX3060(12GB)、背伸びしてGeForce RTX 4070 Ti SUPERやRTX4060Ti(16GB)、ガチなら4090(24GB)というのがおおかたの認識でした。グラボそのものの価格帯は5万から数十万円というイメージでしょうか。
現在はRTX50XXモデル(Blackwell世代)が登場しているわけですが、今年秋頃に5070 Ti SuperがVRAM24GBで出るという噂があり、なかなかグラボ選びの難しい時期かなと思います。もし24GBで出るなら私もほしい!
ローカル生成の楽しさは、枚数を気にせず好きなだけ画像生成できることや、さまざまな拡張機能を使えることが大きいですが、追加学習で自分だけの画風や表現を追求できることもNovelAIなどではできない醍醐味の一つ。せっかくローカル生成に手を出すのであれば、最低限12GB、できれば16GBのVRAMを搭載したグラボを選ぶことをオススメします。
SDXLのライセンス
SDXLの使い方に入る前に、大事なライセンスのお話です。例えばNovelAIやNiji journeyなど、ウェブ上の画像生成サービスで画像生成をする際は利用規約に従うわけですが、オープンソースのソフトウェアを使ってローカル環境で画像生成を行う場合には、ユーザーは使用するモデルに付されているライセンスに行動を縛られることになります。内容はものによって様々ですが、マージや再配布、NSFW利用、生成画像の販売を禁止するもののほか、利用時にモデル名や提供者名の表示義務を課しているものもあります(例:後述するNoobaiXLなど)。
ControlnetやLoRAなどにも個々にライセンスがありますので、CivitaiなどでDLする際は必ず確認するようにしましょう。(例えばControlnetのOpenposeを商用利用する場合、場合によっては年間約250万円のライセンス料が発生します)
StabilityAI社が提供する画像生成AIモデルは「CreativeML OpenRAIL-M」ライセンスか、その拡張版ライセンスで公開されています。これはモデルを無償・恒久で再配布・改変できる一方、差別・搾取・違法行為などの禁止用途を必ず受け継がせる、生成AIモデル専用のライセンス。SDXLのライセンスは拡張版の「CreativeML Open RAIL++-M」です。末尾についている"+"(プラス)は、もとのライセンスに追加の条件、制限、または拡張が加えられているバージョンであることを示しています。
▲SDXL1.0のライセンス全文。必ず一度は読みましょう
・CreativeML Open RAIL++-Mの概要
「CreativeML OpenRAIL-M」ライセンスには、ユーザーに著作権と特許上の無償・非独占ライセンスを恒久的に付与し、出力画像の権利は原則ユーザーに帰属することが明記されています。改変や再配布もOKですが、改変する場合はライセンス内容を継承することが必要です。
SDXLでやってはいけない禁止事項は、末尾の「別表A(Attachment A)」に列挙されていますので、必ず確認するようにしましょう。下図は機械翻訳ですが、現地の法律に違反するような用途全般や児童搾取、偽情報の拡散、個人情報の悪用、誹謗中傷・差別、法的権利を左右するような完全自動の意思決定、医療助言、司法・捜査・移民審査用途などが禁じられています。
他人への嫌がらせ目的や児童ポルノなどを生成するのでなければ、画像生成はNSFWを含め基本的にセーフで、商業利用してもロイヤリティーを取られることはありません。SDXLを利用していることなどをどこかに明記する義務もなく、派生モデルの公開も自由で、取り回しのしやすい内容となっています。
派生モデルもこのAttachment Aを最低限守ることが求められますが、新たに制限を加えることは可能です。初めてDLするモデルの別表は必ずチェックして、生成画像の販売やマージモデルの配布などが禁止されていないか確かめるようにしましょう。
・ライセンスとは別に「利用規約」もある
StabilityAI社は2025年7月31日付けで「利用規約」を変更し、同社の技術を使って性的な画像生成をすることを一切禁じると発表しました。これは各モデルに付与されたライセンスとは別のもので、StabilityAI社の技術を使用する場合、ユーザーは自動的に規約に同意したことになります。
SDXL系モデルは取り消し不可能な永続的ライセンスで「NSFW生成はOK」とされているので、この利用規約変更はSDXLユーザーには直接影響しませんが、ライセンスと規約の二重構造についてはユーザーとしてよく理解しておくことが求められます。StabilityAI社の規約変更については、こちらの記事で詳しく特集しています。
SDXLモデルの「ファインチューン」
SDXLはあくまでベースモデルですので、幅広いタグを理解してさまざまな画像を生成できることを重視して構築されています。ただ、「1girl」で生成するたびに実写画像が出たりイラストが出たりしたら、生成結果が予測しづらくて使いづらいですね。よって、StabilityAI社が提供しているSDXL1.0をそのまま使ってイラスト作りをしているユーザーはあまりおらず、Civitaiなどで流通している人気派生モデルを使うか、自分でマージ(他のモデルと融合)したものを使うことが多いです。
・出汁に味噌を入れて味噌汁にする
ベースモデルに対し、LoRAや別のモデルをマージさせるなどして、特定の画風や特徴に特化させることを「ファインチューン」と言います。
ベースモデルがスープの「出汁」だとすれば、ファインチューンはその出汁に味噌やコンソメを入れてスープに仕上げるようなものです。一度味噌を入れてしまったら、もうそこからコンソメスープに路線変更するのは難しくなりますよね。これと同じように、日本風のアニメイラストに特化させたモデルでは、実写系の生成をプロンプト指示しても効きにくくなりますし、ロリっぽい画風に特化したモデルだと、大人びた頭身のキャラクターが生成しにくくなるわけです。
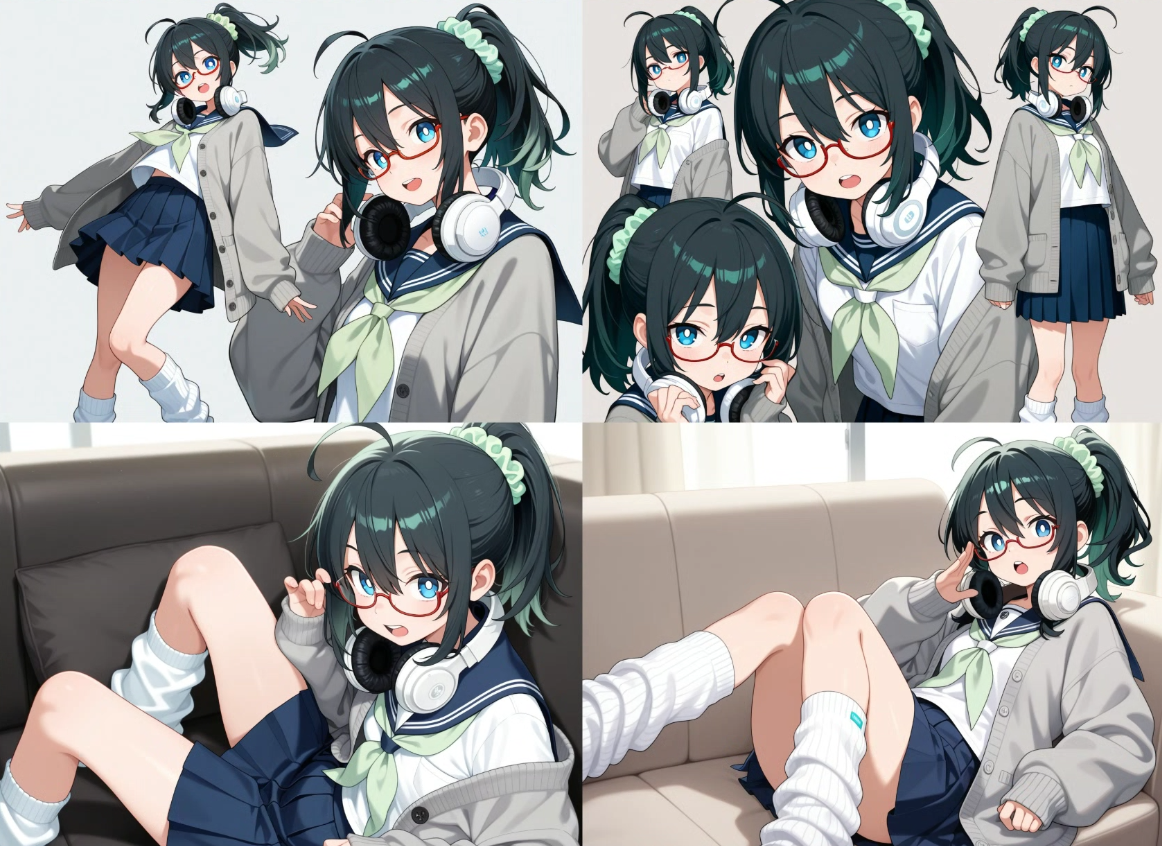
こちらの画像をご覧ください。左の4枚がベースモデルであるillustriousXL1.0で生成したもので、右4枚は私が「自分LoRA」をマージしてファインチューンした独自モデルで生成したものです。どちらも全く同じプロンプト・設定・Seed値ですが、右は画風やタッチがより統一されていることが分かります。(そのかわり、ベースモデルにあった多様性は失われます)
ファインチューン済モデルそれぞれが持つ固有の顔立ちのことを、よく「マスピ顔」と呼びます。NovelAIv1が人気だった時代に、クォリティタグの代表である「masterpiece」を使うと、誰が生成しても同じような顔立ちのイラスト(マスピ絵)が出てきたことが由来。ぱっと見てすぐ「よく見るAI絵だ」と思ったなら、それは何かしらの人気モデルの「マスピ顔」である可能性が高いです。
▲これはChatGPT4oの「マスピ顔」。妙に黄色くなるので分かりやすい
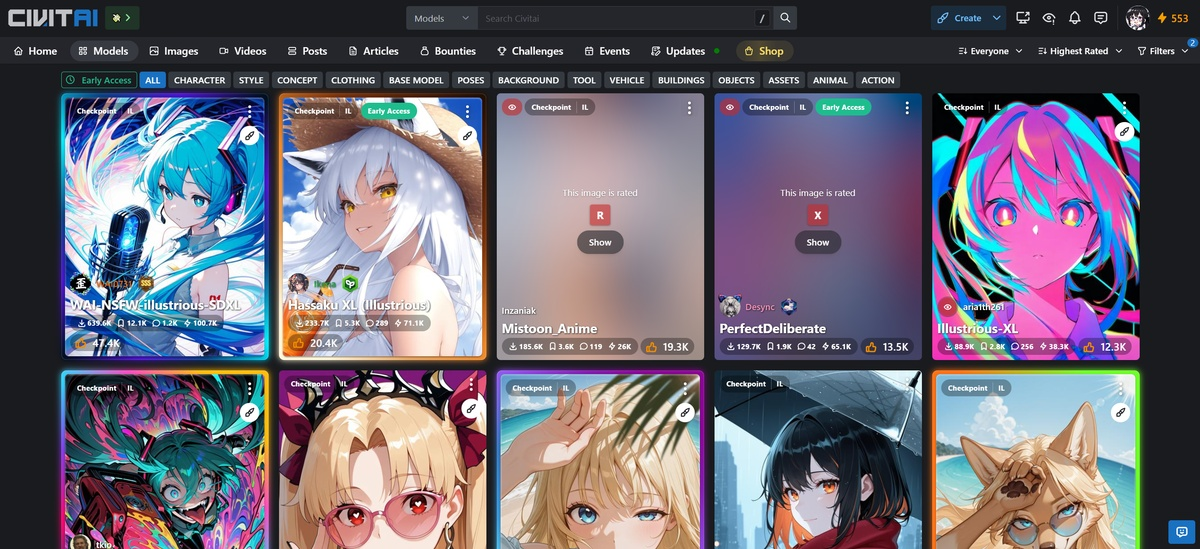
ファインチューンの影響は、"1girl"の顔立ちだけでなく、カラーやタッチ、あらゆるタグをどのように描画するかに関わってきます。世の中には背景描写が得意なモデルや人体描写が得意なモデル、白黒画像しか出ない漫画モデルなど、さまざまなファインチューンモデルが存在しますが、Civitaiでのダウンロード数ランキングなどを見ている限り、2025年夏現在、アニメ調のモデルで最も人気があるのは「illustrious系」と呼ばれる系列のファインチューン済みSDXLモデルと言えるかと思います。
▲Civitaiにあるillustrious系checkpointを人気順に表示したところ
illustriousとは?
「illustriousXL」は、韓国のAI企業OnomaAI社がKohaku XLという既存モデルをベースに構築したSDXL系列モデルです。danbooruタグが使えるほか、自然言語での指示もでき、版権キャラクターの再現やNSFW生成にも優れているのが特徴。アニメ調で調整はされていますが、特定の画風にファインチューンされていない(つまりマスピ顔がない)ため、ユーザーが好みにあわせて調整しやすくなっています。
illustriousXLは2024年9月、チューニング中だった「v0.1」がウェブ上に流出したため、OnomaAIが緊急的にリリースしたという妙な経緯で世に出たモデルです。性能の高さがすぐに評価されて、その後多くの派生モデルが作られました。本来の正式バージョンである「v1.0」は、当初「アーリーアクセス権」が10ドルで販売されていた時期もありましたが、現在は無償公開されています。
v1.0から学習画像サイズが1536x1536pxに拡大されており、SDXLの規定サイズより更に大きいサイズで生成できるようになったのも特徴の一つ。既に後発モデルの「v1.1」「v2.0」もリリースされています。
・黒をより黒く!新訓練法「VPred」
illustrious系をはじめ、最近のSDXLモデルでは、従来のStableDiffusionモデルで採用されてきたトレーニング手法とは異なる「VPred(V-Prediction)」と呼ばれる新手法でトレーニングしたものがデフォルトとなりつつあります。従来の手法である「ε‑pred」で訓練したモデルに比べ、収束ステップが少なく済んだり、色ズレや色飛びが起こりにくかったりする利点がある一方、VPredに対応したwebUIでないと画像生成ができない点に注意が必要です。(Forge、reForge、forge Classic、ComfyUIは基本的に対応しているようです)
こちらは左がε‑predモデル、右がVPredモデルで生成した「black background」の画像。黒さにはっきりとした違いがみられます。
このように、従来のε‑pred訓練モデルでは、ノイズ除去の仕組み上、どうしても中間的な明るさの色合いになりやすく、「真っ黒」「真っ白」といった画像を出そうとしてもやや灰色がかってしまうことがよくありましたが、VPredで学習されたモデルはよりプロンプトに忠実な彩色ができるようになっています。
基本的には、モデルの説明書で推奨されているCFGスケールやステップ数、サンプラーで生成すれば問題なく使用できるはず。「VPredって書いてあるやつは新しくてちょっと性能がいいのね」「生成できなかったらwebUIが対応してないのね」くらいに覚えておけばOKかと思います。
・ライセンスは「FAIPL」
illustriousXLのライセンスはSDXLと同じCreativeML Open RAIL++-Mではなく、「Fair AI Public License 1.0-SD」(以下FAIPL)です。Civitai上では「illustrious Licence」と表記されることもあるようです。
FAIPLの特徴は、利用者に強いオープンソース精神を求めることにあり、派生モデルをクローズドにしてお金儲けをしようとたり、勝手に厳しいライセンスを設けたりすることを禁じています。ファインチューンした派生モデルを公開することはできますが、その場合、他の人も同じものを作れるように、利用したデータセットやどんな比率でマージしたかのレシピを公開することが義務づけられています。
CreativeML Open RAIL++-Mは派生モデルに「Attachment A」などの継承を求めていますので、FAIPLはこれに従い、同文の禁止事項が盛り込まれています。
冒頭に「SDライセンスとの互換性を保つために禁止用途のセクションを設けている」と書かれていますが、CreativeML Open RAIL++-Mの求める全文転載と変更点の注記は満たしていないように見えます。ただ、出力物の権利がユーザーにあることや、NSFW生成が自由である点は変わりません。
・自然言語プロンプトをサポート
illustriousXLは基本的にはdanbooruタグでトレーニングされていますので、単語をカンマで区切って呪文のように並べていく「1girl,smile,sky...」形式で生成するのが基本ですが、「An anime girl is smiling...」式の自然言語プロンプトにも対応しています。
▲長文の自然言語プロンプトで生成した画像
ただ、illustrious系は指示された内容に敏感に反応して、すべての指示を満たす結果を生成しようとするあまり、長文の自然言語では画像が低劣化したり、文脈のおかしな画像になりがち。(smile:1.5)のような単語ごとのプロンプト強調も、自然言語ではできません。
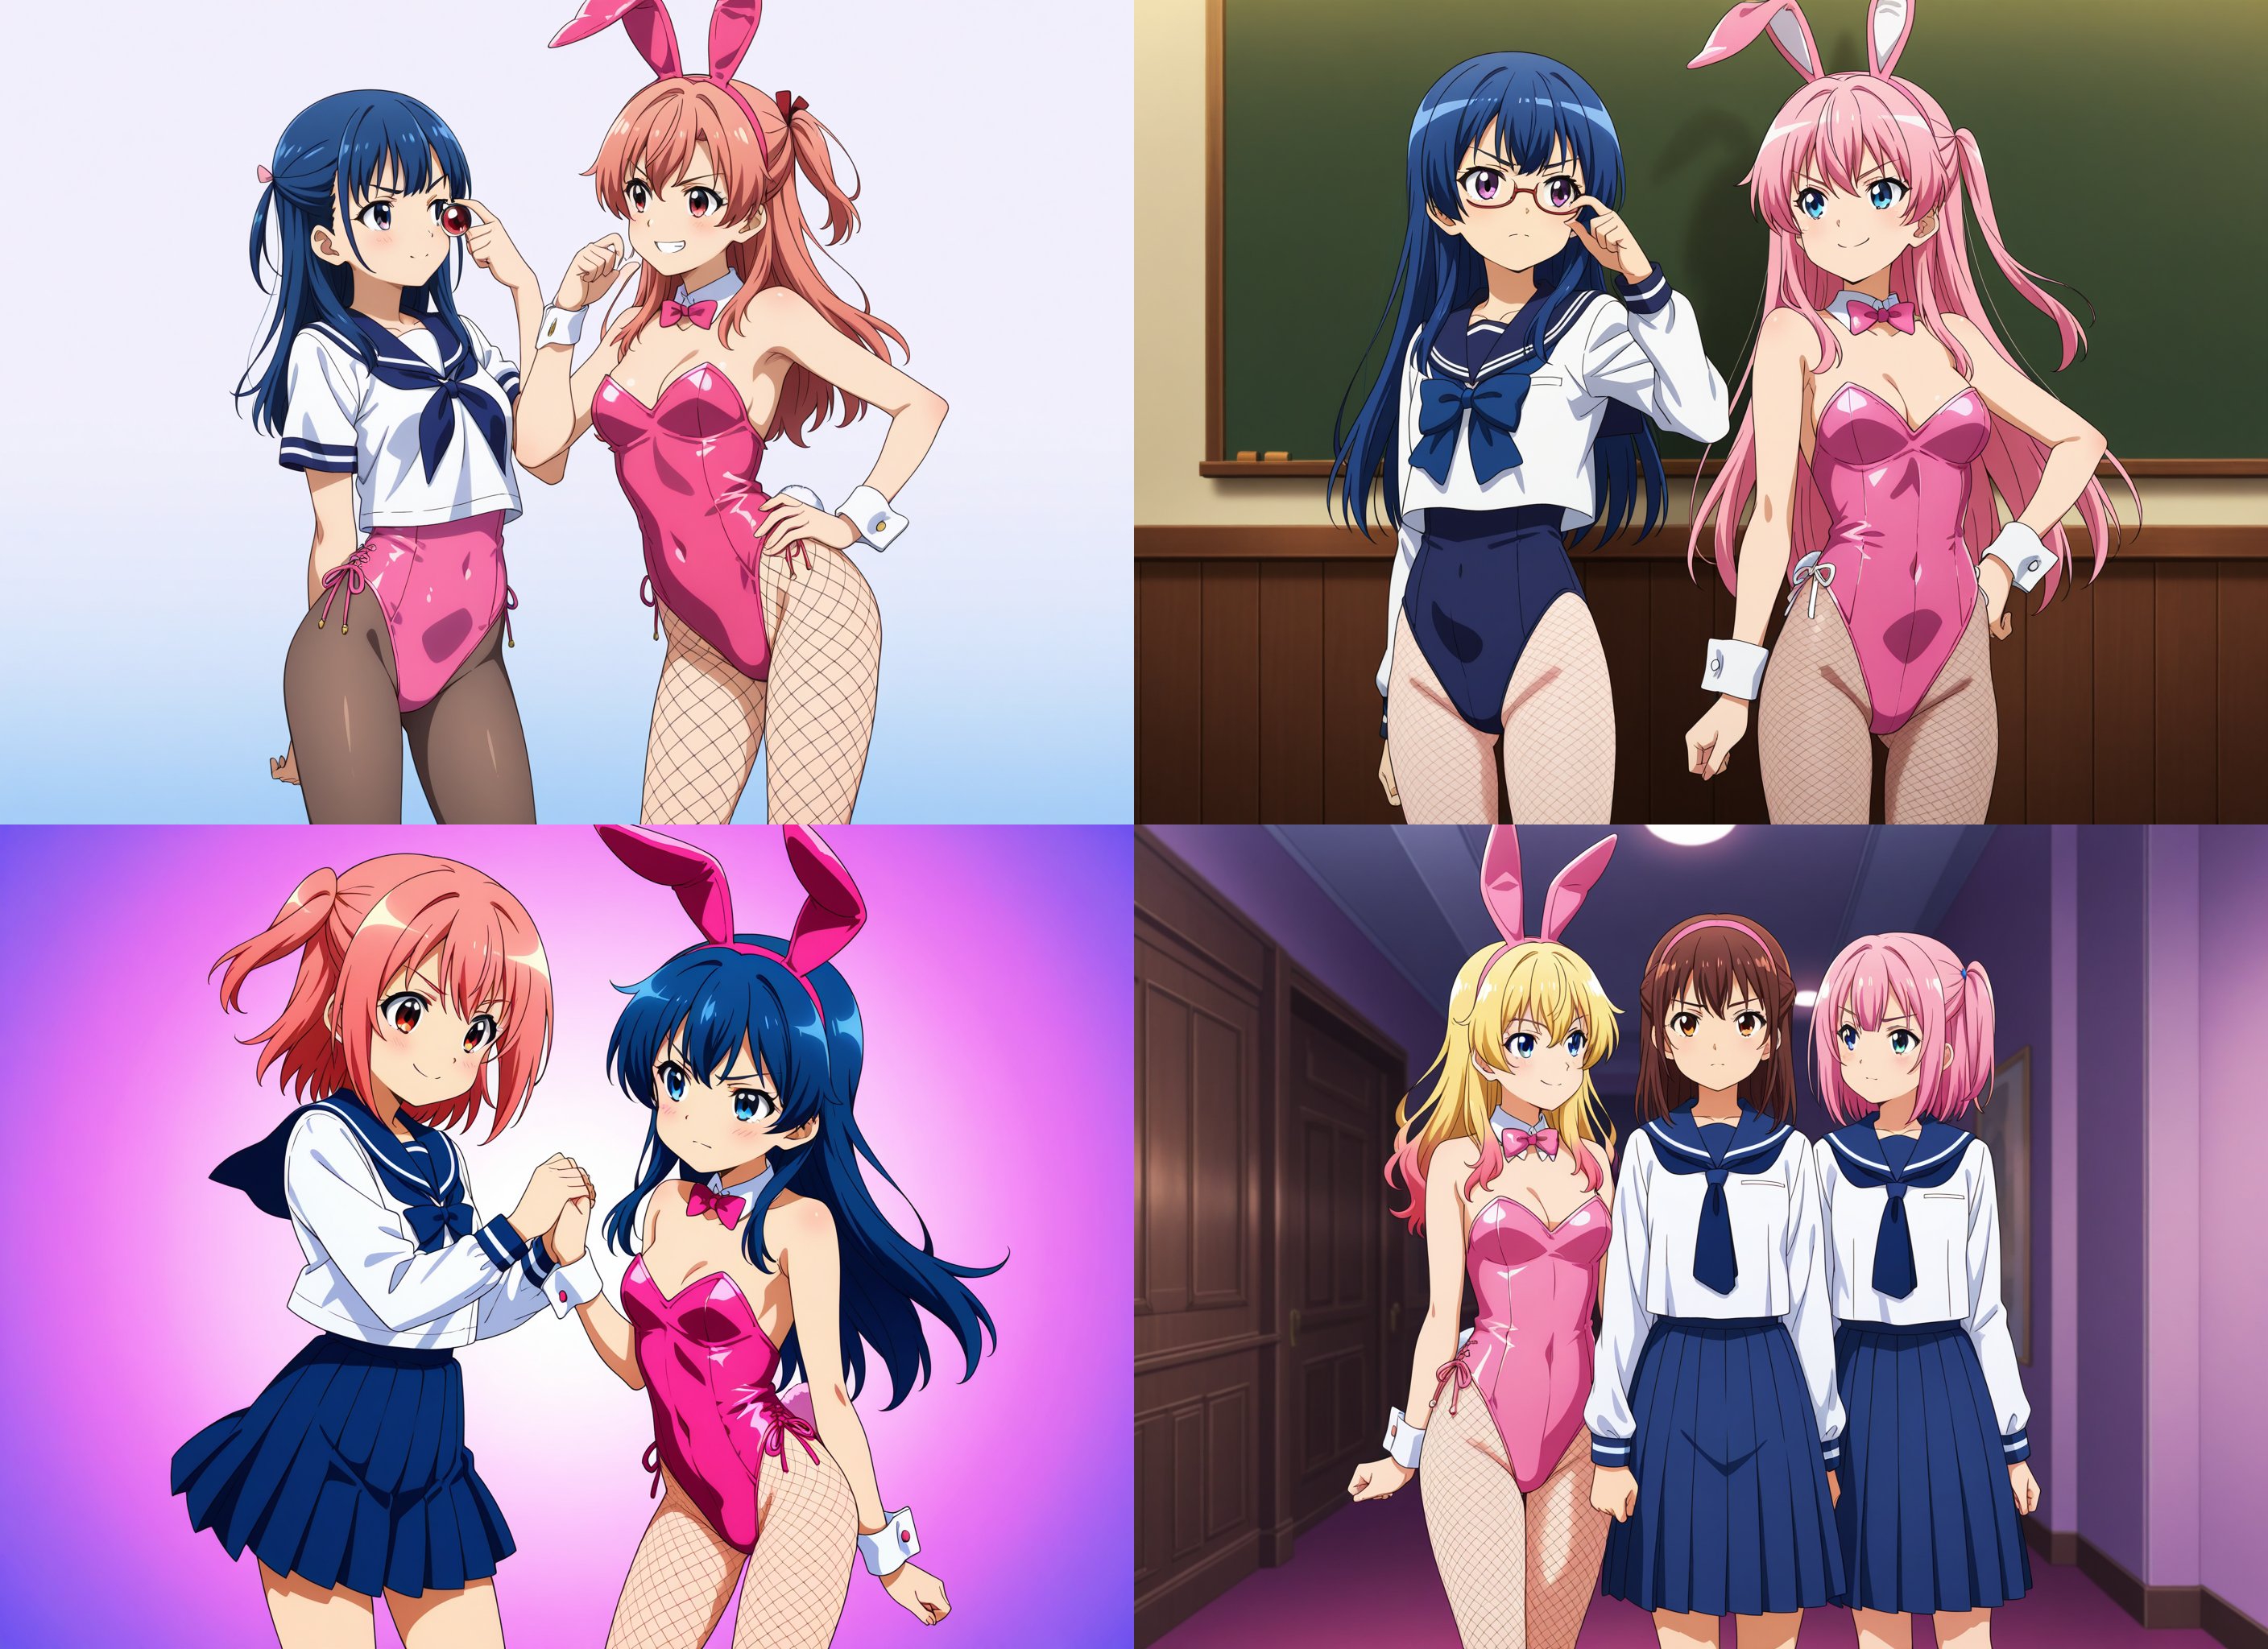
個人的な所感としては、基本は「1girl...」式のdanbooruタグで記述し、主語述語を間違えてしまったり、複数キャラの容姿を描き分けたりしたい場合に、例外・補助的に自然言語プロンプトを使うのが良いかなと思います。例えば、「2人の女の子の画像。紺色のセーラー服の子は笑っていて、ピンクのバニーガールは怒っている」をdanbooruタグで記述するとこのように混じってしまいますが…
このように自然言語を使うと、やや理解が改善します。
ただ、打率がやや改善する程度で、完璧に指示できるわけではありません(下図)。自然言語プロンプトはあくまでdanbooru式の指示では再現が難しい場合に、補助的に使用するのが良いかなと思います。
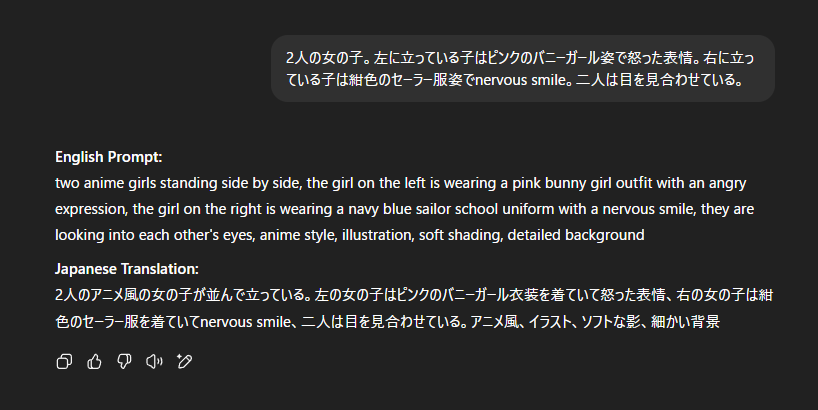
ちなみに、自然言語プロンプトはこのようにChatGPTなどに依頼して作ってもらうのが手っ取り早いです。
・illustrious系の人気派生モデルは?
Civitaiでは、Base model欄の「illustrious」にチェックを入れることで関連checkpointやLoRA、Controlnetなどを検索することができます。
Civitaiで流通しているillustrious系の人気モデルシリーズとしては、スタジオ真榊のプロンプト大辞典でも利用した主流モデル「WAI-NSFW-illustrious-SDXL」を始め、
・Noobai-XL
・Obsession (Illustrious-XL)
・NTR-MIX
・HassakuXL(illustrious)
・Illustrious XL personal merge
などの人気モデルがあります。いずれもillustriousXLを源流にファインチューンされたモデルです。
このうち「Noobai-XL」は、「画像販売の禁止 / 利用時のクレジット明記義務 / マージモデル配布の禁止」などを明記した厳しいライセンス内容で知られていますので、利用する場合はご注意ください。illustrious系の中にはNTR-MIXなどNoobai-XLがマージされているものも多く、それらはモデル自体の販売・サービス化だけでなく、生成した画像の商用利用も禁止されています。(詳しくは下記記事参照)
・WAI-NSFW-illustrious-SDXLについて
WAI-NSFW-illustrious-SDXLは、WAI0731氏がillustriousをベースにファインチューンしたアニメ系モデルです。ライセンスはillustrious licence(FAIPL)で、NSFW生成や画像の商用利用が可能となっています。
記事執筆時点の最新バージョンはv14.0。プロンプト大辞典の生成例に使用されているのもこちらです。このバージョンからベースモデルがillustriousXLのv1.0となったため、従来のSDXLモデルより大きいサイズでの生成ができるようになりました。
WAI-NSFWシリーズは非常に多くのバージョンが公開されているのが特徴ですが、過去のバージョンでは「v9」が特に品質が良かったとされ、v14.0が公開された現在も愛用されているようです。v14.0は安定性重視のため、v13.0ほど新しいデータセットを用いていないとのことで、過去のモデルのほうが幅広いプロンプトに対応できるという報告もあります。
▲v14.0の「マスピ顔」ミナちゃん。パキっとした彩度高めのアニメ塗りが特徴
SDXLでローカル環境入門
ここからは、これからSDXLでローカル生成を始める方向けに、最短経路で画像生成まで進む道のりを紹介します。(※「AIイラストが理解る!」の内容はおおむね理解している前提で説明していきます)
・ローカル環境を「StabilityMatrix」で構築
まずは自分のPC内で画像生成できる環境を整えるところから。「StabilityMatrix」というアプリケーションを使うと、A1111版、Forge、ComfyUIなどの主要UIを一括でインストールできる上、使用するcheckpointも共有できるので、初心者にも熟練者にもオススメです。環境構築は基本的にこちらの記事をベースに進めれば問題ないはず。
初めて使用するwebUIは、2025年夏現在なら「reForge」か「Forge classic」をおすすめします。黎明期はAutomatic1111氏版StableDiffusion webUIが唯一の選択肢でしたが、現在webUIをどれにするかは幅広い選択肢があり、まず初めてStableDiffusionを触るなら、初心者にも分かりやすく、解説記事が充実しているForge系がよいと思います。こちらの記事で詳しく解説していますが、起動・生成スピード重視ならシンプルなClassic、拡張機能重視ならreForgeがおすすめです。
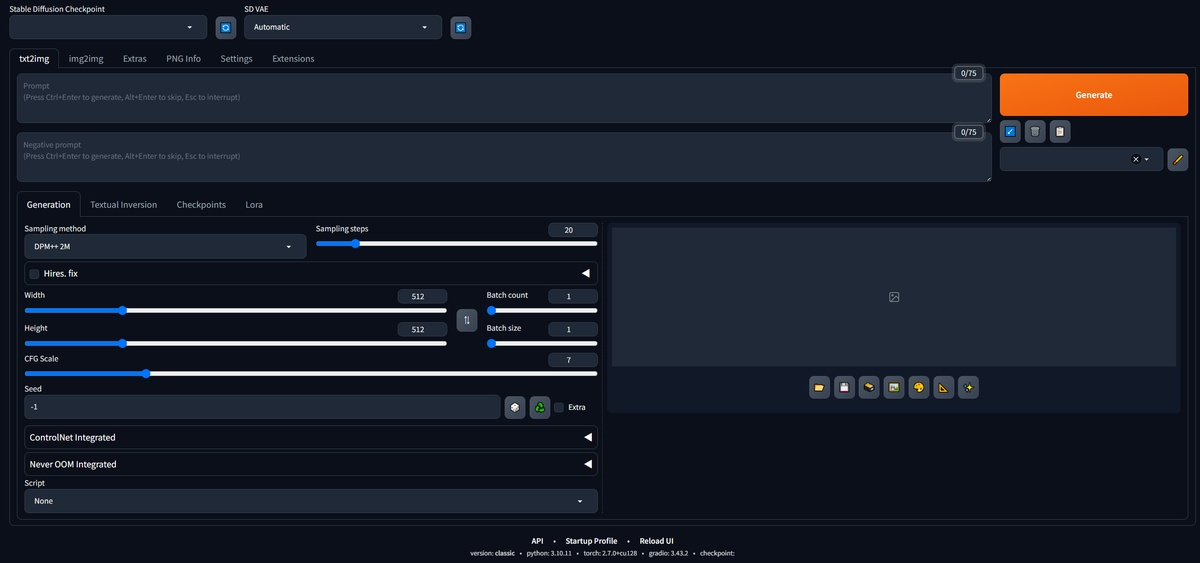
こちらが「Classic」の起動画面。StabilityMatrixの紹介記事の通りにやれば、ここまではすぐたどり着けると思います。
ゲーム風に言うと、これで生成に必要な「ハード」は揃ったので、今度は「ソフト」をDLしましょう。つまり、AIそのものであるtext to imageモデル(checkpoint)のことですね。Civitaiにあるillustriousモデルの中から好みのものを選んでDLし、「Data\Models\StableDiffusion」に配置すればOK。ここでは先ほど紹介した人気モデル「WAI-NSFW-illustrious-SDXL」のv14.0を選びます。
左上のタブで「v14.0」が選択されていることを確認し、画面右側の「↓」ボタンからダウンロードができます。画面左側には、モデルの解説やおすすめの生成設定などの情報が書かれていることが多いです。
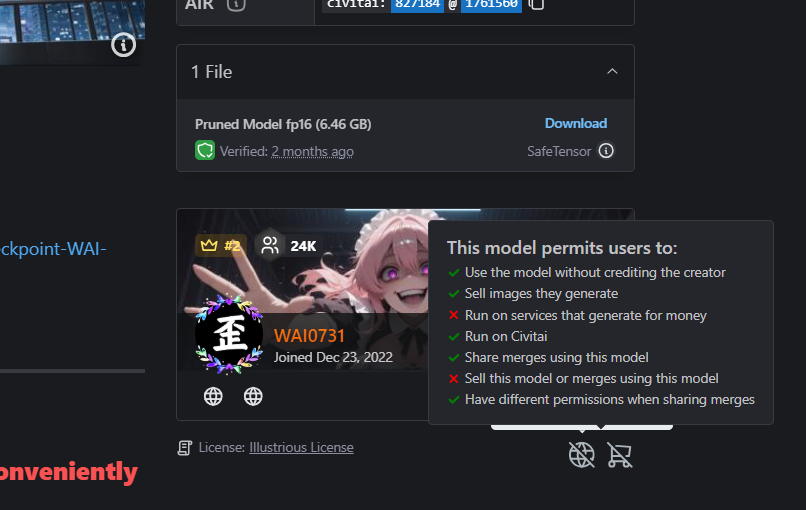
画面右側のこちらから、Licenseが「illustrious Licence」(=FAIPL)であることが確認できます。とても小さな表記ですが、非常に重要ですので、DL前にかならず確認しましょう。(LoRAやControlnetもCivitaiからDLする場合はここにライセンス表記があります)
その右側のアイコンはCivitai独自の表示で、このモデルで生成画像を販売してよいかや、クレジットが必要かどうかを示していますが、時折ライセンス内容と矛盾していることがあるので、アイコンだけ見て早合点せずきちんとチェックしましょう。
ちなみに、生成画像の色合いを左右する「VAE」は、WAI-NSFW-illustrious-SDXLの場合checkpointに同梱されていますので、DLしなくてOK。VAEを変更するとどうなるか試してみたい場合は、Civitaiで下図のようなSDXL用のVAEを探して「Data\Models\VAE」に配置しましょう。
・WAI-NSFW-illustrious-SDXLで生成してみよう
webUIの日本語化もまだですが、これで必要なものは最低限揃いましたので、さっそく生成してみましょう。v14.0を使って生成する際の公式推奨設定は以下の通り。
サンプラー:Euler a
ステップ:15~30
CFGスケール:5~7
CLIP SKIP:2
生成推奨サイズ:1024x1024pxより大きいサイズ(長辺2048pxまでなら大きく破綻しない模様)
VAE:checkpointに統合済のため不要
推奨アップスケーラー(Hires):R-ESRGAN 4x+ Anime6Bでノイズ除去強度 0.35~0.5とし、サイズは1.5倍、ステップは20前後にするのが公式推奨
レーティング:全年齢の「general」、少しきわどい「sensitive」、エッチな「nsfw」、露骨な「explicit 」の4種類。(詳しくはプロンプト大辞典参照)
推奨クォリティタグ:masterpiece,best quality,amazing quality
推奨ネガティブプロンプト:bad quality,worst quality,worst detail,sketch,censor,
左上の入力欄から順番に、これらを画面上で入力していきましょう。プロンプト(テキスト)から画像(イメージ)を生成したいので、「txt2image」のタブを選びます(デフォルトで選択されています)
まずStableDiffusion checkpointでさきほどDLした「WAI-NSFW-illustrious_v140.safetensors」を選び、VAEは「automatic」、CLIP SKIPは2、CFGスケールは5、ステップ15、生成サイズは1280x1280pxとします。枚数は1枚でOK。「seed」はランダムを意味する「-1」とします。SamplingMethod(サンプラー)は「Euler a」です。
▲入力例(スクショはUIを日本語化済のもの)
プロンプトは青空背景で笑顔の女の子が生成される「1girl,smile,sky,masterpiece,best quality,amazing quality,general」です。このモデルは「NSFW」とついている通りH生成がガンガンできるモデルなので、「general」と入れておかないとあられもないイラストになりがちです。ネガティブプロンプトは公式推奨の「bad quality,worst quality,worst detail,sketch,censor」。これで、右上にある「generate」ボタンを押しましょう。
注文通り、青空背景で笑顔の女の子が全年齢モードで生成できました!エッチな画像を生成してみたい方は、「general」を「nsfw」に変えて、「プロンプト大辞典」のX章を参考にプレイ内容などのタグを書き加えてみましょう。
ここまでできれば、あとはStabilityMatrixの紹介記事の通りにローカル環境を使いやすく整備し、下記の記事を中心に基本を習得していけばOKです。プロンプトが分からないときは「大辞典」が参考になるはずです。お疲れさまでした!
版権キャラクター再現と著作権
現在流通しているアニメ調のローカル用モデルはNovelAIと同様、多くの日本の版権キャラクターの容姿を学習しており、キャラクター名や作品名のタグで再現が可能です。つまり、そうした二次創作的な画像を生成した場合、その画像の扱いには著作権法の理解とリスク管理が必須となります。
生成物に既存の著作物との「類似性」と「依拠性」があり、その著作物の「表現上の本質的特徴を直接感得」できてしまう場合、その生成物の利用は著作権侵害とみなされます。そうした生成物を私的利用の範囲を超えて利用する場合は、著作権者から提訴されるリスクがあることを十分に理解した上で行うようにしましょう。ウェブ上でただキャラクター絵を無償公開するだけでも、「公衆送信権侵害」とみなされ、損害賠償を求めて提訴される恐れがあります。また、再現したキャラクターや使い方によっては、著作権とは別の権利を侵害してしまうこともあります。
SNSでは日常的に版権キャラの二次創作イラストを見かけますが、これは版権者にとってビジネスの障害にならないファンアートの文脈であることや、ファン活動を法的に咎めるとビジネス上のデメリットが大きいという合理的理由があるために黙認されているだけ。私も「機動戦士ガンダム 水星の魔女」という作品が大好きで、Xで二次創作活動を行っていますが、こうした行為は版権側が「提訴したメリットの方が上回る」と判断した場合、多額の損害賠償責任が生じる恐れがあることを十分に理解した上で、自己責任で行う必要があります。
普段キャラ絵を描いている人は感覚が身についていると思いますが、初めて画像生成で二次創作に触れる場合はこのあたりの理屈が分かりにくいので、よくよく注意しましょう。「手描きではみんなやっているから大丈夫では?」と思うかもしれませんが、例えばそのキャラの著作権者が画像生成AIに強い嫌悪感を持っていた場合、「手描きファンアートは黙認するがAIを使った模倣は絶対に許さない」ということで、ピンポイントで自分だけ提訴されてしまうかもしれません。
SNSではよく「学習は著作権法上合法」という主張がみられますが、仮にそうだとしても「生成は全て合法」というのはまず間違いです。そして学習段階でも、いわゆる「狙い撃ち学習」の場合は違法となる恐れがあると文化庁は整理しており、「AI無罪」どころか、露悪的な使い方をすれば手描きよりAIの方が危険と言えるでしょう。そして、投稿内容がファンアートの文脈から外れるほどに(つまり公式やキャラへの敬意が感じられない画像の場合)、法的責任を追及される可能性がより高まる点にも注意が必要です。
「キャラをまねていても、画風が原作と似ていなければ類似性がないのでOK」という言説もよく聞きます。そうかもしれませんが、似ているかどうかを判断するのはユーザーではなく警察や裁判所です。例えばこちらはAIで作ったエヴァポスターをネットオークションで販売して摘発されたケースですが、報道写真を見る限り原作と画風は似ておらず、むしろよくある「マスピ顔」であることが分かります。
警察が「うーん…これはスタジオカラーや貞本先生のタッチと違ってSD1.5系のマスピ顔だからセーフ」と言ってくれるわけはなく、有名作品のキャラでおおっぴらにお金儲けをしたら摘発されるのは当たり前のことです。最終的に法廷で無罪(もしくは勝訴)を勝ち取ったところで、そこまでに掛かった年月と裁判費用、感情コストを取り戻すことはできません。自分の身は自分でしか守れませんので、余暇の趣味で巨大なリスクを背負い込まないようにしましょう。
SDXL向け画像生成サイズ
SDXLは1024x1024pxの画像でトレーニングされていますので、これより小さいサイズで生成すると生成精度が下がる傾向にあります。一方、これより大きすぎるとキャンバス全体が崩壊して、物体や体の一部が分裂して繰り返し生成される奇形現象が起こってしまいます(下図参照)
キャンバスサイズは64の倍数にするのがよいとされているので、だいたいのイメージとして、正方形なら「1280x1280」、縦型なら「1024x1536」、横型なら「1536x1024」くらいが基本かなと思います。特にNovelAIと併用する方は、規定サイズが同じですので取り回しがしやすくなります。(キャンバスが細長すぎると感じたら1408x1024pxくらいがオススメ)
縦横比は構図を決定する上で非常に重要なので、出したい構図に応じて慎重に検討しましょう。生成サイズをボタンで選べる拡張機能「Aspect Ratio selector」(▲)
に各サイズを登録しておくと、呼び出すのが楽なのでオススメです。(下記記事の"⑤:生成サイズをボタンで一発選択"を参照)
ちなみに、「1984x704px」のような極端なアスペクト比でも生成は可能ですので、SNS用のバナーなどを作る際は活用してみるとよいでしょう。
一方、illustriousXL1.0系のモデルでは、1536x1536pxまでの解像度を安定して処理できるようになっています。WAI-NSFWv14.0などの派生モデルではより大きいサイズでの一発生成も可能ですが、長辺と短辺の平均が1536pxを超えるようなサイズ(例:1536x2048px)だとやはり奇形化現象が起こりますので、過信は禁物。やはり1024x1536px程度が基本ではないかと思います。
サンプラー選びについて
SDXLもノイズ除去によって画像生成(サンプリング)を行っているわけですが、そのノイズ除去の手法のことを「サンプリングメソッド」または「サンプラー」と呼びます。サンプラーが違うと、全く同じ設定でも違う画像が描き出されますが、SDXL系においては、「Euler A」と「Euler」が最もメジャーで、とりあえずこれを選んでおけばさほど問題はないとされています。
特に最新の「V-Pred」モデルで生成する際は、EulerかEuler A以外のサンプラーを使用すると画面が崩壊するなどの不具合が生じてしまいます。SD1.5時代はユーザーによって好みのサンプラーが多種多様だったのですが、現環境では多くのユーザーがEulerAを選んでいるようです。
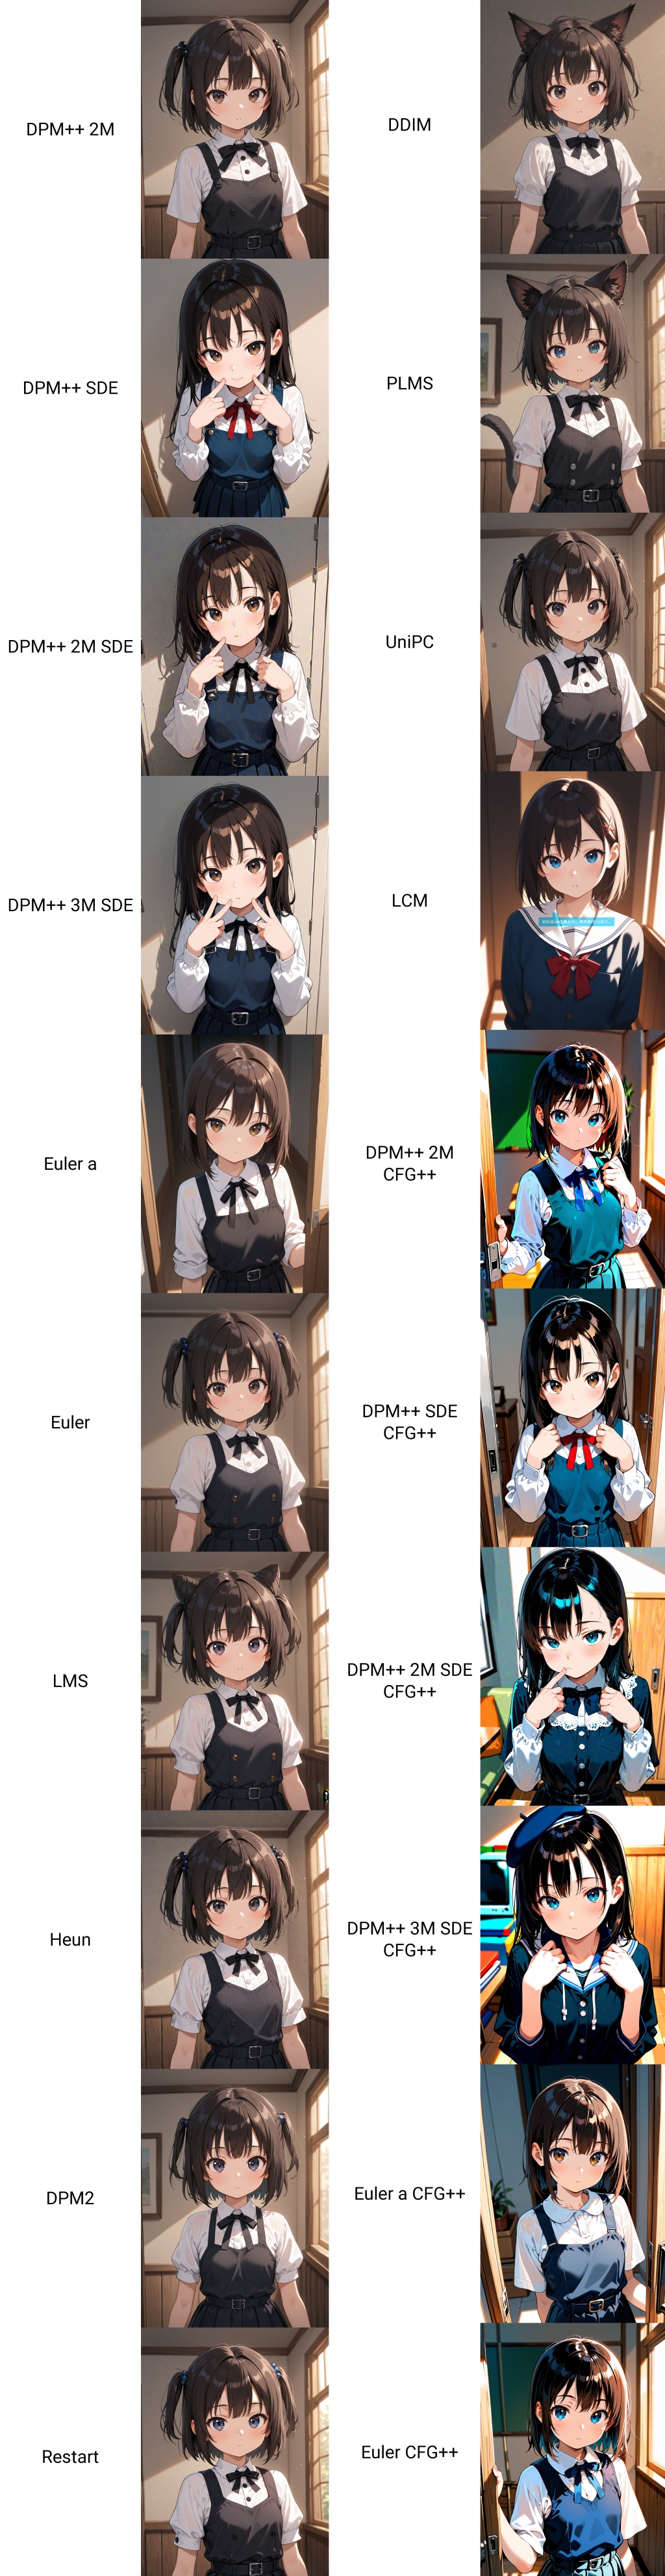
こちらはWAI-NSFWv14.0で、さまざまなサンプラーを使って同じ「1girl」を生成した例。
このように、サンプラーによってSD1.5時代に比べてそこまで大きな違いがあるわけではないようですし、特別な理由がなければEuler系でよいかなと感じています。
ちなみに、Euler Aの「A」は「Ancestral」のことで、ステップごとにノイズを加えては除去することで品質を上げる試みを指しています。逆に言えば絵が収束しにくいわけで、ステップを上げるほどに絵が変わっていく特徴があります。(NovelAIにある「Euler Ancestral」は、ローカルでいう「Euler A」です)
SDXL系のControlnet
プロンプト指示では不可能な画像コントロールを可能にしたのが、Controlnetと呼ばれる機能です。ある画像を参照させることで、その線画部分を継承して塗り直したり、一部だけを描き替えたり、ラフを清書したり、タッチだけを変えたりと、さまざまなコントロールが可能になります。SDXLにおいては、SDXL用にトレーニングされた各種Controlnetが充実しています。
▲CNモデル「Scribble」でラフを清書したもの。画風のコントロールも可能
Controlnetを使うためには、checkpointやLoRAのように「Controlnetモデル(以下、CNモデル)」を所定のフォルダにダウンロードする必要があります。CannyやDepth用のSDXL向けCNモデル(拡張子:safetensors)は、代表的なものがこちらのリンク先でまとめられているほか、個人配布のモデルをCivitaiなどでDLすることができます。
Forge系のwebUIでは、基本的にデフォルトでControlnetがインストールされていますので、あとはControlnetモデルをDLするだけで使うことが可能。StabilityMatrixを利用してwebUIをインストールした方は「Data/Models/Controlnet」フォルダの中に各種CNモデルを配置しましょう。
・Noobai系CNモデル
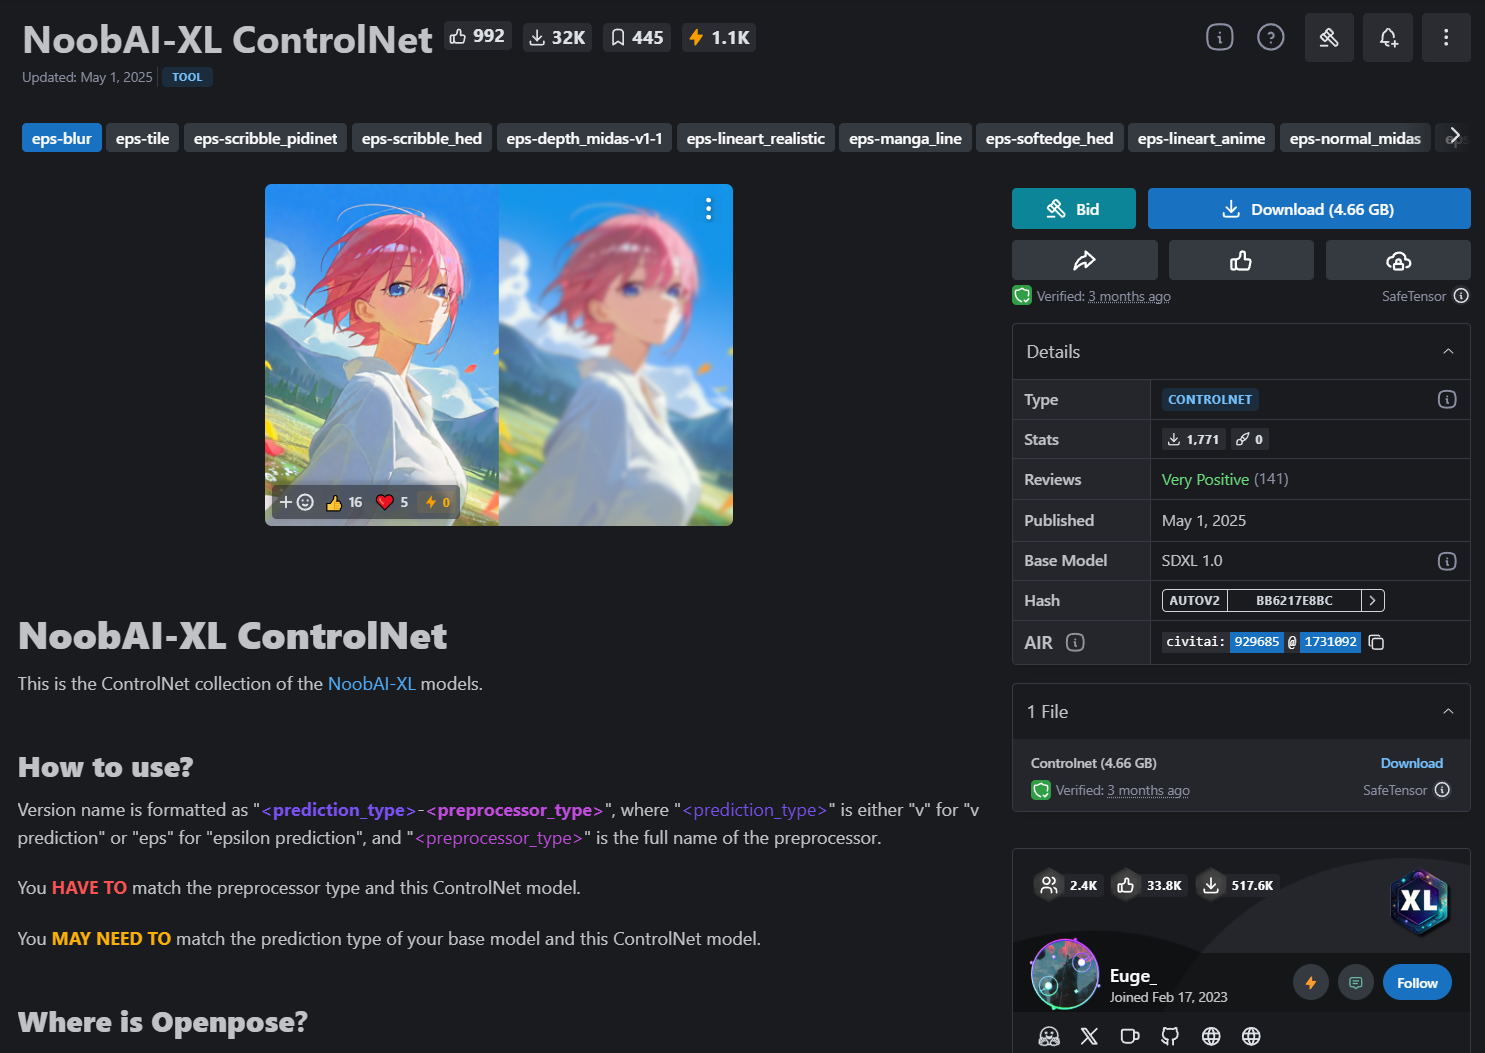
最近、特に性能の高さを感じているのがNoobai用にリリースされている各種Controlnetです。(リンク先はCivitai)
NoobAI-XL ControlNetを開いたら、各種CNモデルを上のタブから選択し、「Download」ボタンからDLすることができます。Noobai系ではないSDXLモデルでもおおむね問題なく使用することができるようです。
おすすめは、画像の一部を描き直せる「インペイント」、線画継承できる(つまり塗り絵ができる)「Lineart anime」あたり。特に、インペイントはNovelAIに迫る性能の高さを示しており、破綻修正や文脈のあるイラストづくりに役立ちます。
基本的な使い方や設定方法は「SDXLControlnetが理解る!」を参照のこと。Controlnetを使った各種テクニックの記事はこちらから一覧表示できます。
「自分画風」のファインチューン
冒頭で触れた「ファインチューン」を自分で行うやり方についても触れておきます。SDXL用のLoRAはCivitai上で多数共有されており、キャラクター再現や画風のコントロール、特定ポーズを再現するものなどを入手することができますが、自分で好みの画風で描けるLoRAを作ってモデルをファインチューンすることも可能です。
LoRAは基本的に数枚から数十枚(多くは15枚くらい)の画像データセットを学習させることで、それらに共通する概念を覚えさせる手法ですが、「コピー機LoRA法」という手法を使うと、1枚絵から画風を抽出することもできます。
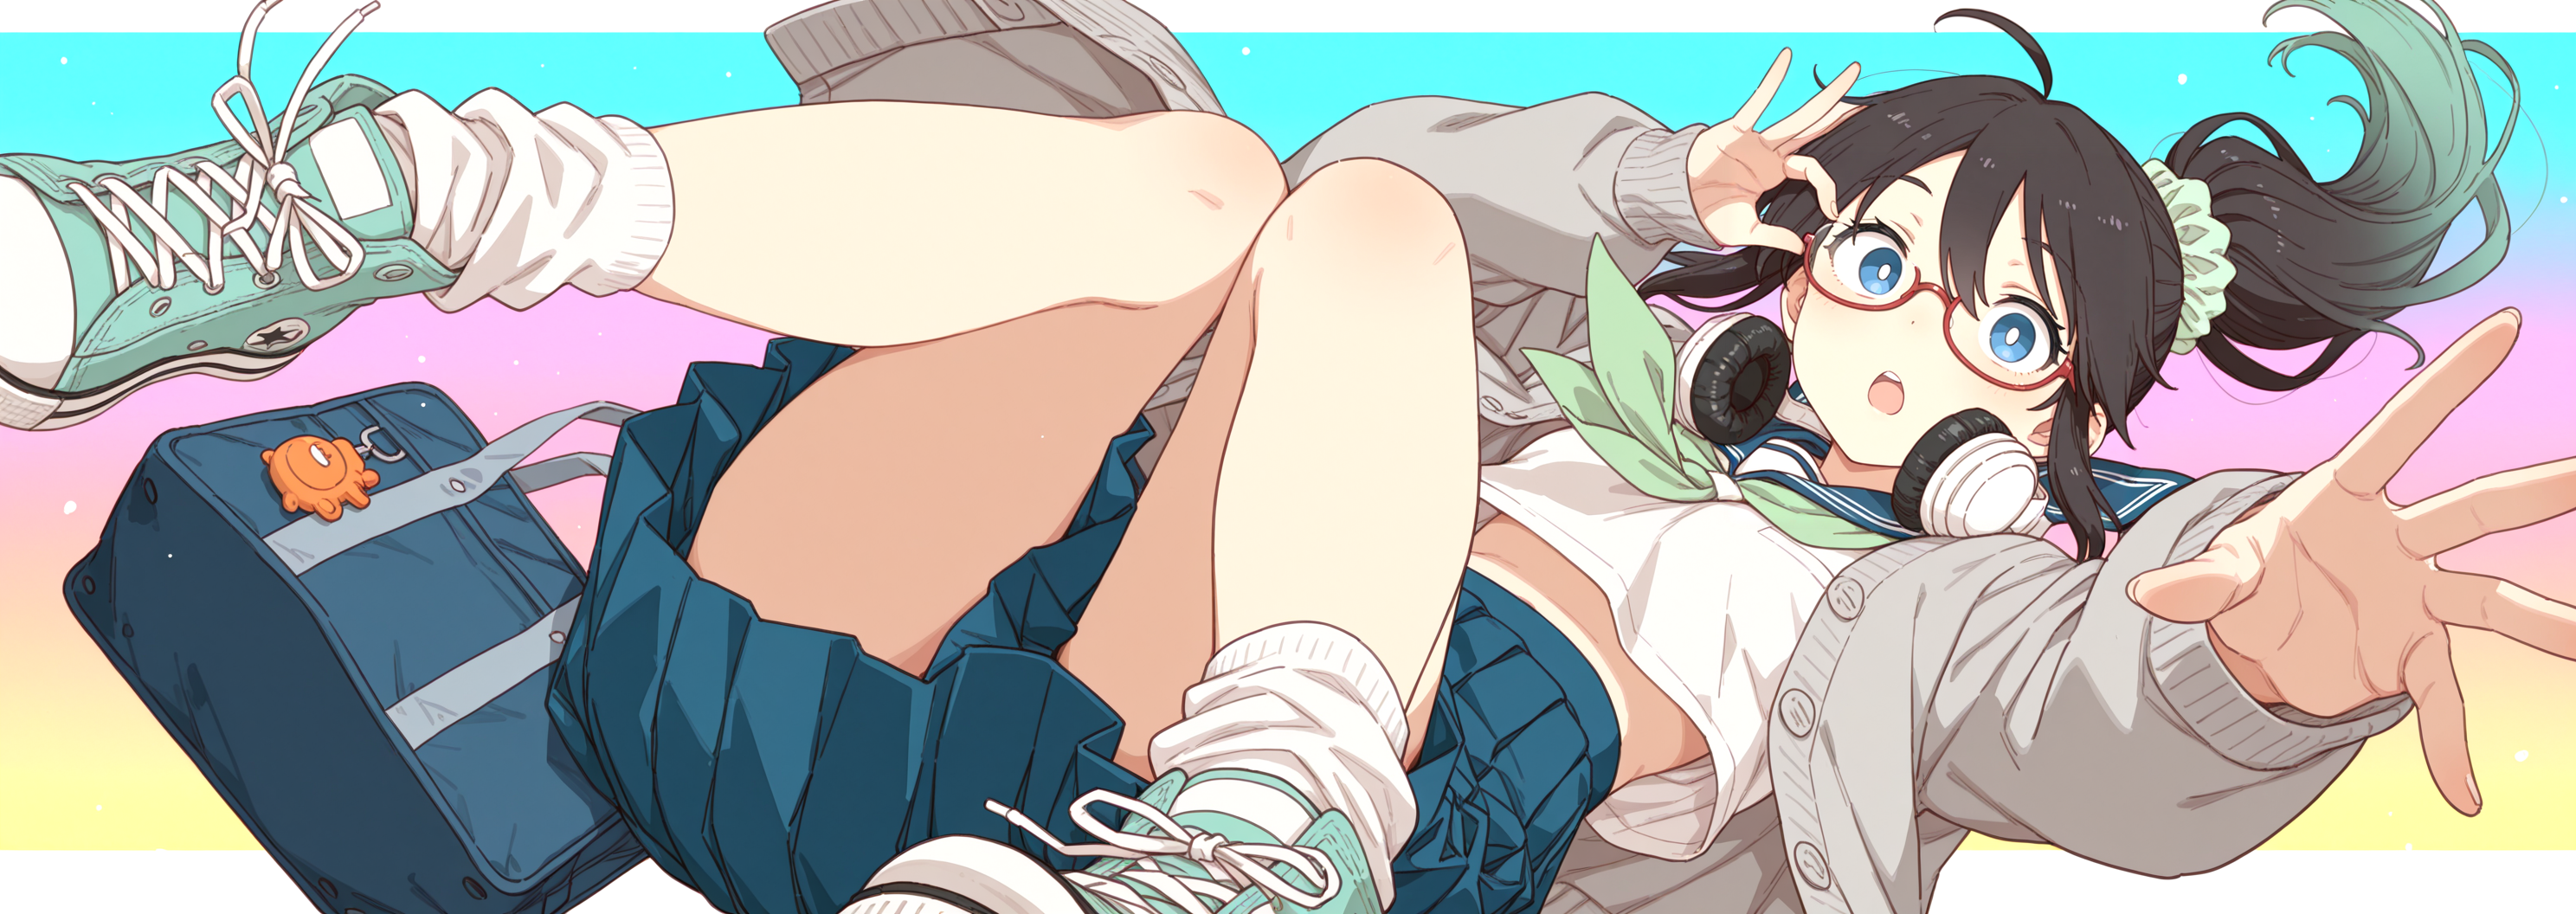
例えばこちらの一枚絵を学習させることで…
「1girl」を生成するとこのように画風が再現されるLoRAを作ることができます。LoRAをcheckpointにマージすれば、常にこの画風で描かれるモデルを作れるわけです(1枚絵ならではの限界もあり)
コピー機LoRA法は自分でイチからやろうとするとなかなか面倒なのですが、とりにく(@tori29umai)さんのアプリ「CoppyLoRA webUI」を使うと簡単に学習することができます。詳しいやり方はこちらの記事で解説しています。
終わりに
以上、illustrious主流の現環境をベースに、SDXLについての基礎知識をまとめました。寄せられる質問を読んでいますと、2025年になってからローカル環境(≒SDXL)を触るようになった新規ユーザーさんは、テック系に関心が高い方よりも、もともと絵が描ける方や漫画作りの経験がある方が意外と多いようです。AI絵をメインに作品を作りたいというよりは、手描きで作っている自分の作品の一部(背景など)をAI補助で作画効率をアップしたいと考えていたり、最新環境では実際どこまでのことが可能なのか調べたりしたい需要があるようです。
「好きなキャラクターのこんな絵が見たい!」という需要は、高価なグラボなどをそろえなくてもNovelAIでおおむね叶ってしまうわけですが、NovelAIではControlnetや画風の追加学習といったことができません。特に、漫画作品の中で、背景や物品、モブ、難しいポーズなどを自分の画風で生成したい場合は、枚数制限のないローカル環境での生成が最適ということになります。
世間では依然として、生成画像を作品に使うことには否定的な見方が強いわけですが、これから描こうとしているイラストのポーズや構図、カラーやライティングを何百枚も生成して「イメージボード」として使うだけなら、プロの作画現場や打ち合わせでも意外と行われているようです。特に難しいパースの効いた構図を手描きで描く場合、ローカル環境で事前にさまざまなサンプルを生成して案出しできるのはメリットなのかなと思います。
毎年ローカル環境は大きく変化していますし、2025年も後半戦に入ってくると、またillustrious系とは別の新しいモデルが広がっていくことが予想されます。引き続き、現環境で最も取り回しが良いモデルやその使い方を、ライセンスなどの注意事項にも触れながらウォッチしていきたいと思います。
それでは今回はこの辺で。スタジオ真榊でした。
Files