Home

 Creators
 Search
 Recent
 Random
 Posts
 DMs
 Tags
 Random
 Importer
 Import
 FAQ
 Account
 Register
 Login
 Favorites
 Keys
 Logout
 Telegram

着せ替え可能な高性能キャラLoRAを作ろう! (Pixiv Fanbox)
Content
こんばんは、スタジオ真榊です。今回は、タグ付けをしっかりと使いこなすことで、1つのキャラLoRAに複数の容姿(服装や髪型バリエーション)を学習させる方法についてまとめたいと思います。追加学習にはいつも通りanimagineXL3.1を使用し、こちらの「SDXL用LoRA学習が理解る!」でひととおり基本的なLoRA学習のやり方を理解していることを前提として書いていきます。
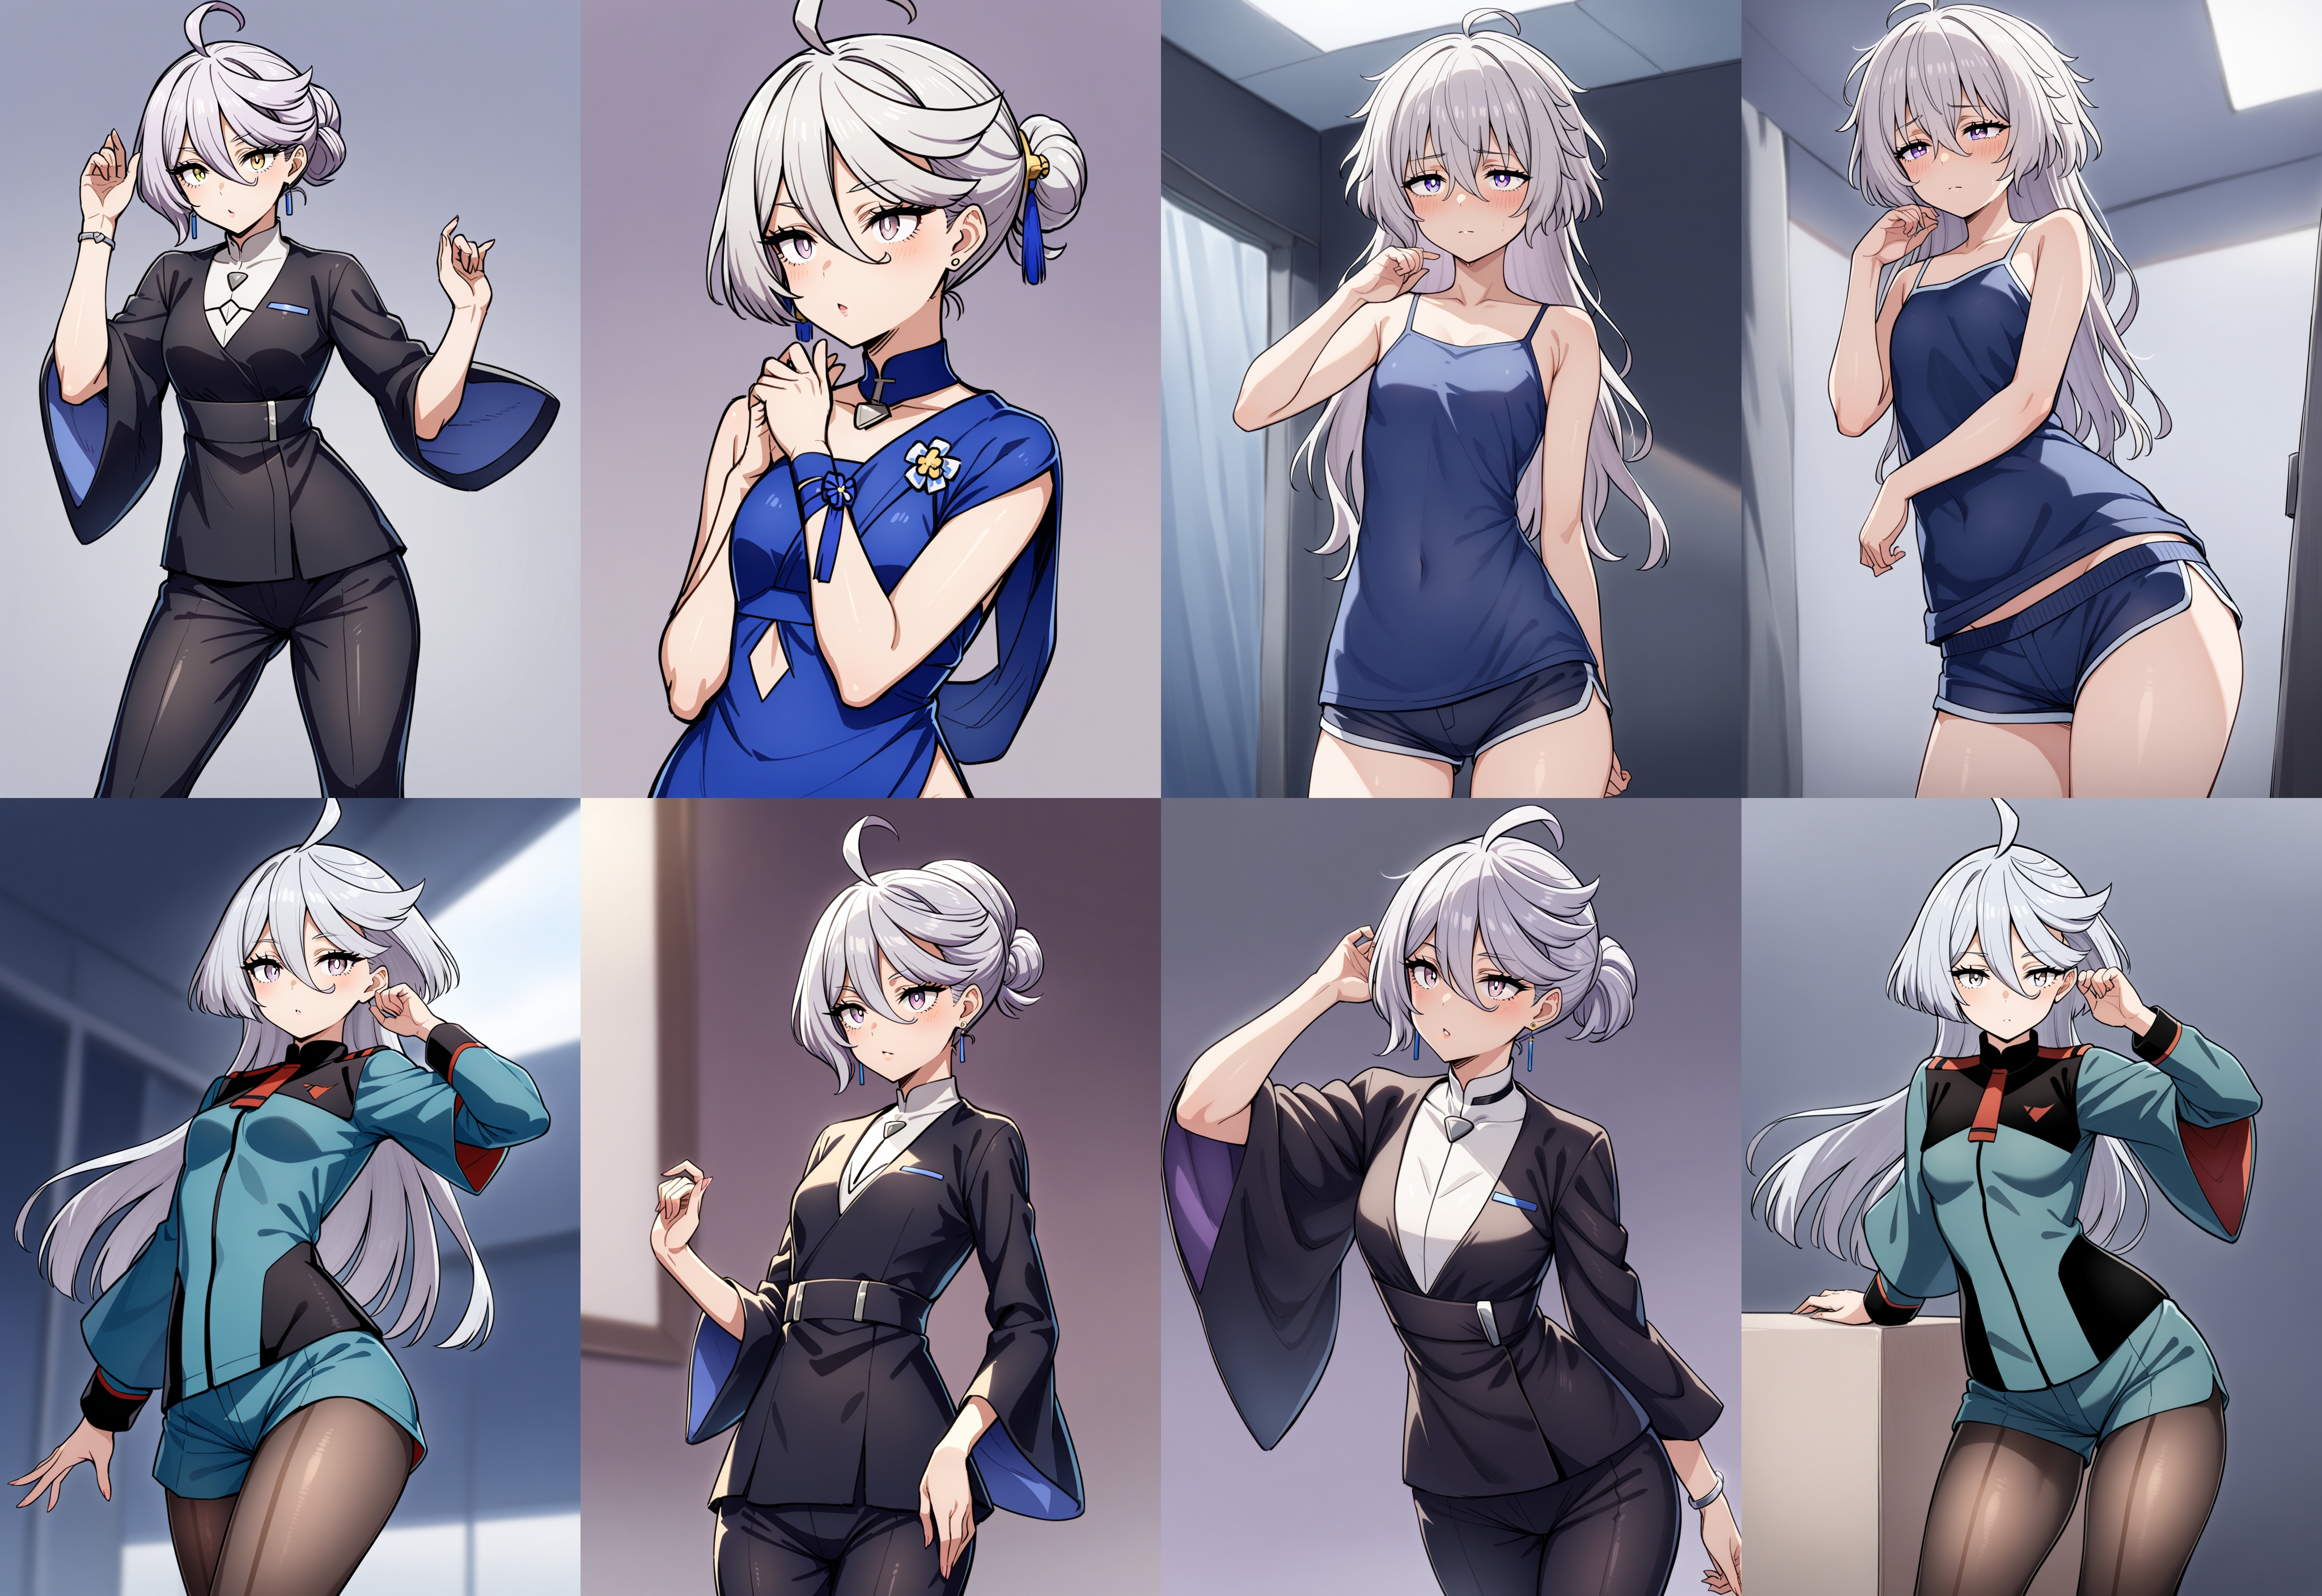
今回検証したのは、このような「複数の容姿バリエーションを持つ1人のキャラクター」のLoRAを作る際に、それぞれ「スーツミオリネLoRA」「ドレスミオリネLoRA」を個別に作るのではなく、一回のLoRA学習でこれらすべての容姿をいっぺんに覚えさせ、独自タグで自由に呼び出すやり方です。
このLoRAを適用して「miorine_rembran」と打ち込むと制服姿に、「suitmio」と打ち込むとスーツ姿に、「dressmio」と打ち込むとドレス姿で生成することができ、服装だけでなく髪型やアクセサリなどもそれに応じて変化させることができます。
この手法は、いわゆる「マルゼンスキーム(マルゼン式、マルゼン法)」と日本で呼ばれるものとは少し異なります。マルゼンスキームは「キャラの顔立ちのみ」「衣装のみ」を個別に覚えさせて組み合わせる手法ですので、例えば衣装だけを別のキャラクターに着せることも可能ですが、ミオリネスキームはあくまで「それぞれの姿のそのキャラクター本人」を顔や髪型も含めて覚えさせる手法ですので、そうしたことはできません。
それぞれ異なるルールのタギングが必要なので、この記事では両方のやり方について取り上げたいと思います。
目次
1.画像収集とフォルダ分け
<創作的表現の模倣に注意>
2.狙ったキャラのみをトリミングするには
3.リネーム&背景削除&画像サイズをそろえる
①リネームから始めよう
②背景削除
③リサイズ
4.仕組みを理解してタギングする
<トリガーワードは"暗号"にした方がいい?>
<トリガーワードが分からなくなったら>
5.具体的なタギング手順
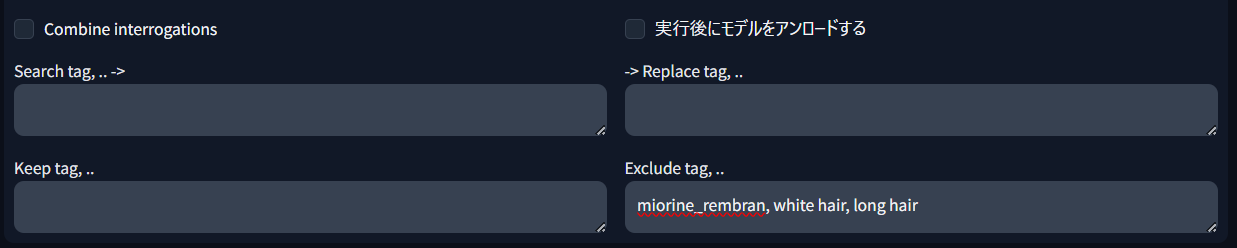
<Exclude Tagsをメモしておこう>
<学習開始前に必ずタギングチェック>
<リピート数はどうする?>
6.学習設定
7.着せ替え可能な「マルゼンスキーム」のタグ付け
8.できたLoRAで生成してみよう
9.衣装デザインが混じってしまったら?
10.終わりに -「作品LoRA」もできる?-
1.画像収集とフォルダ分け
この手法は、フォルダ分けとタギングが非常に重要です。まず、集めた画像を正しくフォルダ分けする手法から説明していきます。
例えば、一人のキャラクターに5つの容姿があるとします。その場合、画像保存フォルダを5つ作るのがこの手法の第一歩になります。下図をご覧ください。
LoRA/ ←ルートフォルダ(名前はなんでもよい)
└ training/ ←学習データを入れるフォルダ(名前はなんでもよい)
└ miorineloraXL/ ←LoRAごとに作るフォルダ(名前はなんでもよい)
├ 4_miorine_rembran/ ←デフォルト(制服)姿の画像を保存
├ 4_bosarine/ ←ぼさぼさ頭の画像を保存
├ 4_suitmio/ ←スーツ姿の画像を保存
├ 4_3ylatermio/ ←3年後の姿の画像を保存
└ 4_dressmio/ ←ドレス姿の画像を保存
普段は数字とアンダーバーから始まる画像保存フォルダは一つのみで作ってきましたが、今回はこのように、名前の異なるフォルダを5つ用意し、それぞれの名前に対応する画像を振り分けることにします。制服姿の画像がスーツ姿のフォルダに混入したりしないよう、注意して振り分けましょう。各フォルダのリピート数(頭の数字)はとりあえず4としておきます。
用意する画像は各フォルダ最低20枚あれば十分で、それぞれのフォルダで画像数をそろえる必要はありません。いつも通り「量より質」を念頭に、魅力的な画像ではなく「再現したい容姿の特徴をよく捉えている画像」をできるだけバリエーション豊かにそろえてください。ほかのキャラクターが描かれているイラストは避けるか、soloで描かれているものを使ったほうが容姿の混在を避けられるでしょう。
<創作的表現の模倣に注意>
教師データの収集には「imgbrd-grabber」などのダウンローダを使うと便利ですが、自己防衛のため、サイト規約や国内の関連法、米国のフェアユースの概念などをきちんと理解した上で、学習段階でやってはならないことを踏まえて利用しましょう。
例えば「あるイラストレーターの作品である少量のイラストのみを学習データとして、その創作的表現の全部または一部を出力させるために著作物を収集する場合」、イラストレーターから許諾を得ないと画像の複製行為(LoRA学習目的のダウンロード)が違法となる可能性があります。
(※文化庁「AI と著作権に関するチェックリスト&ガイダンス」(令和6年7月31日)より引用)
収集したデータセットを基にこれからLoRAで再現しようとしているものが、著作権保護されない「アイデア」にとどまるものなのか、それとも著作権保護される「表現」に至っているのかのラインは司法判断になりますが、いまだ判例はありません。ただ、もし訴えられたらその時点で大トラブルに巻き込まれているわけですから、法廷で勝てるかどうかではなくまずはラインに近づかないこと、ウェブ上で露悪的な振る舞いをしないことが何より大切な自己防衛策であろうと個人的に考えています。
2.狙ったキャラのみをトリミングするには
さて、そのキャラクターが大きく映った画像だけで学習させたほうが高品質なLoRAができますが、普通に集めると、別のキャラクターが映り込んでいる画像も多く集まるのではないかと思います。完全にsoloの画像だけでデータセットを構築すると、2girlsと指定してもsoloになりがちな現象が起こるのでそれはそれで問題ですが、できれば他のキャラクターはフレームアウトし、覚えさせたいキャラが大きく描かれた画像を多めにしたいところです。
多数の画像を一枚一枚画像編集ソフトで開き、トリミングし、サイズを指定して保存するのはなかなか面倒ですので、私は有償のファイル管理アプリ「Eagle」を使ってトリミングしました。
まずはトリミングしたい画像をフォルダごとドラッグアンドドロップ。各画像をクリックして開くと、右上に「クロップ」ツールのボタンがあります。
これをクリックしてトリミングしたい範囲を選択したら、もう一度同じボタンを押せば、一瞬で上書きトリミング完了。あとは次々に手作業でやっていくだけでOKです。(※上書きせず、元画像を残す場合は「として保存」を押します。日本語訳が変ですねw)
導入方法やアプリの詳細はこちらから。LamaクリーナーなどもEagle上で動かせるので、購入する価値は十分にあると思います。
3.リネーム&背景削除&画像サイズをそろえる
①リネームから始めよう
だいたい1フォルダあたり20~100枚程度の画像をそろえられたら、背景削除やリサイズを行う前に、まずNameryなどのソフトを使って一斉リネームすることを強くお勧めします。名前はフォルダごとに「suitmio01、02、03…」「bosarine01、02、03…」のように、もし混じってしまってもどのフォルダの画像だったか分かるようにリネームしましょう。(※下記はランダムなファイル名をzarakimina01~に一括変更した例)
②背景削除
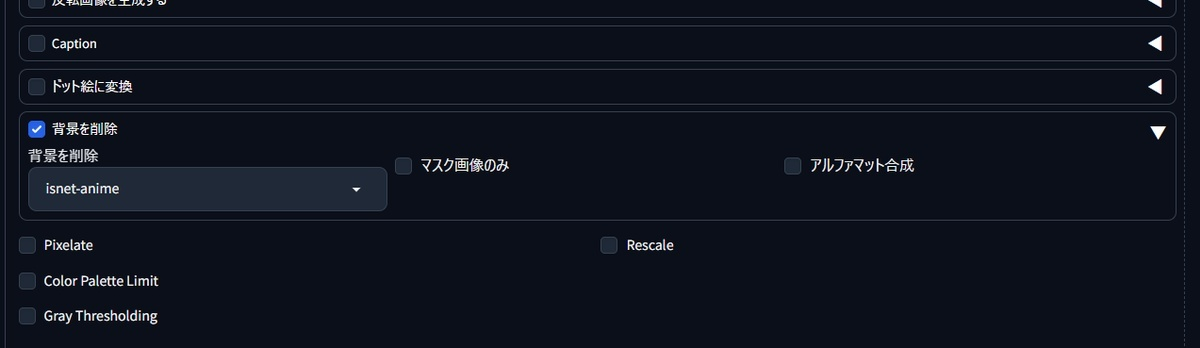
今回作るのはキャラLoRAですので、背景は基本的に必要ありません。「SDXL用LoRA学習が理解る!」で説明したやり方で、用意した画像をすべて背景削除してください。このとき、5つのフォルダを一つずつ処理するのは面倒なので、フォルダ分けした画像をいったんどこかのフォルダにまとめて、一斉に処理すると良いでしょう。
エクスプローラーの検索窓に「*」もしくは「*png」や「*jpg」と打ち込むと、その階層以下の全ての該当ファイルが一斉表示されますので、画像だけを選択して別の場所にカットアンドペースト(コピペではなく)するのが手っ取り早いです。背景削除がうまくいかなかった画像(キャラの一部まで削除されたしまったもの)を見つけたら、削除前の背景ありの画像を使用することにしましょう。背景のある画像が一部混在していても、LoRAの出来に悪影響はありません。
(※そのキャラクターの背の高さなどを覚えさせたい場合は、多少他のキャラクターや背景を残して学習させたほうが良いこともあります)
③リサイズ
最後に、背景削除されたデータセットを一斉リサイズします。私はいつもどおり「縮小革命」で短辺1024pxに統一しました。長辺も短辺も1024pxに大きく足りていないものが多い場合は、いったんSDwebUの「Extra」タブでアップスケーラを使って大きくした後に、縮小革命で縮小すればOKです。
さきほど画像をコピペでなくカットアンドペーストしてあったはずなので、5つのフォルダはそれぞれカラになっているはずです。別の場所のフォルダに「背景除去済」「リサイズ済」の画像が揃ったら、さきほどリネームしたファイル名を頼りに、再びもとの5つのフォルダに画像を戻していきましょう。
そう、最初にリネームしたのはこのとき元のフォルダに加工済の画像を戻すのが楽だからです。もしランダムなファイル名だったら「これはドレス姿のフォルダで、これはスーツ姿のフォルダで…」と目視で整理しなければならないところでした。
下記のようなフォルダ構成になっており、サイズも1024px前後にそろっていれば、画像の準備は終了です。
LoRA/ ←ルートフォルダ(名前はなんでもよい)
└ training/ ←学習データを入れるフォルダ(名前はなんでもよい)
└ miorineloraXL/ ←LoRAごとに作るフォルダ(名前はなんでもよい)
├ 4_miorine_rembran/ ←制服姿の画像を保存(背景除去・リサイズ済)
├ 4_bosarine/ ←ぼさぼさ頭の画像を保存(背景除去・リサイズ済)
├ 4_suitmio/ ←スーツ姿の画像を保存(背景除去・リサイズ済)
├ 4_3ylatermio/ ←3年後の姿の画像を保存(背景除去・リサイズ済)
└ 4_dressmio/ ←ドレス姿の画像を保存(背景除去・リサイズ済)
4.仕組みを理解してタギングする
次に、最も重要なタギングのフェーズです。今回のLoRAでは、キャラ名のタグを入れると「もっとも登場機会の多いメインの姿(ミオリネさんなら緑色の制服、ウマ娘ならデフォルト勝負服)」が描画され、そのほかの衣装も「bosarine」「suitmio」などのトリガーワードで再現できるLoRAを作る…という発想でした。
このようなLoRAにしたい場合、タギングのルールは次のようになります。
①4_miorine_rembran
トリガーワード:「miorine rembran」
除去するタグ:「white hair」「green jacket」「seamed-legwear」など制服ミオリネの容姿に関わるもの全て。
除去しないタグ:「asticassia school uniform」やポーズ、背景などのその他タグ
②4_bosarine
トリガーワード:「bosarine」
除去するタグ:「miorine rembran」と、「messy hair」「tank top」などボサリネの容姿に関わるもの全て。今回は「sad」(悲しい表情)も除去した。
除去しないタグ:ポーズ、背景などのその他タグ
③4_suitmio
トリガーワード:「suitmio」
除去するタグ:「miorine rembran」と、「black pants」「wide sleeves」などスーツミオリネの容姿に関わるもの全て。
除去しないタグ:ポーズ、背景などのその他タグ
④4_3ylatermio
トリガーワード:「3ylatermio」
除去するタグ:「miorine rembran」と、「black jacket」「formal」など3年後ミオリネの容姿に関わるもの全て。
除去しないタグ:ポーズ、背景などのその他タグ
⑤4_dressmio
トリガーワード:「miorine rembran」
除去するタグ:「miorine rembran」と、「blue dress」「single hair bun」などドレス服ミオリネの容姿に関わるもの全て。
除去しないタグ:ポーズ、背景などのその他タグ
「miorine rembran」と入れたら常に制服姿を描いてくれるLoRAにしたいため、①は「asticassia school uniform」ではなく「miorine rembran」をトリガーワードにしておき、②~④からは「miorine rembran」を除去します。②~④にはそれぞれ固有のトリガーワードを1つめのタグとして配置します。
それぞれのフォルダごとに、その再現したい容姿に関わる全てのタグ(髪色、目の色、髪型、服装、服の色、アクセサリ等)を除去します。ボサリネのみ「sad」を除去したのは、ボサリネさんを描くときは常に悲しげな表情がついてきてほしいからで、これは特殊なケースですね。もちろんsmileなどと併用すれば笑顔にできますが、こうしておくことによって少し愁いを帯びた笑顔になることを狙います。
<トリガーワードは"暗号"にした方がいい?>
トリガーワードを決める際、「suit_miorine_rembran」「miorine_suitver」のような、ほかのタグと似通った単語は使わないことをおすすめします。画像生成の仕組み上、タグのスペルが似ているとそちらに強くひっぱられるので、暗号に近いトリガーワードの方が純粋にデータセットの内容を再現できます。
今回「suitmio」など「~mio」までのトリガーワードにしたのはそういう理由。とはいえ「smr」や「ms」といった暗号化しすぎたトリガーだと忘れてしまうので、ある程度は法則性があったほうがいいと思います。
<トリガーワードが分からなくなったら>
ちなみに、トリガーワードが分からなくなってしまったら、SDwebUI上のLoRA一覧から「i」ボタンを押せば学習の詳細情報が分かるようになっています。ここを見れば、たくさん並んでいる一番前にあるタグがトリガーワードであることが分かります。(ほかの人が作ったLoRAでもこの方法でトリガーワードや学習データセットの内容が推察できます)
5.具体的なタギング手順
では、さっそく上記のルールにのっとってタギングしていきましょう。記事執筆時点の最新タガー「WD EVA02-Large Tagger v3」を使い、フォルダごとに個別にタグ付けをしていけばOKです。(導入方法は理解る!を参照のこと)
おのおののトリガーワードをadditional tagsに入れ、除去するタグをExclude Tagsに入れます。「しきい値(Weight threshold)」は0.28~0.35前後、最低抽出率は0にするのがオススメ。キャラクター名をトリガーワードにしたい場合、検出タグの中にも同じタグがおそらく検出されているはずなので、その場合はAdditional tags、Keep tags、Exclude Tagsにいずれも同じタグを入れればOKです。(理解る!の"Keep tagsの使い方"参照)
<Exclude Tagsをメモしておこう>
例えば、スーツ姿のミオリネさんを描きたい場合は「black jacket」「white shirt」「short hair」などを除去していくわけですが、ここで除去したタグはつまり、そのキャラの容姿を示すタグでもあるわけです。あとでそのキャラを生成する際のトリガーワードの一部としても機能しますので、メモしておくとよいでしょう。LoRAを試作する際は、何度も作っていくうちにどれがどんな狙いで作ったのか分からなくなってしまうことがありますので、トリガーワードやフォルダ分け、データセットやタグ付けの狙いなどについても書き留めておく「LoRA学習メモ」を作っておくと便利です。
ただ、生成時に「white shirt」と入れると、ミオリネさんの未来的なシャツではなく現代的な襟のワイシャツが出てしまうこともあるので、一概にExclude Tagsを入れれば再現度が上がるというわけでもありません。「できたLoRAに学習が甘い要素があれば、Exclude Tagsからそれを補うタグが見つけられることもある」…程度に覚えておくとよいかと思います。
<学習開始前に必ずタギングチェック>
「理解る!」でも念押ししましたが、タギングが済んだら最後に必ず、学習データセットのフォルダを開いて、いくつかテキストファイルを開いてみてください。
どのファイルを開いても、一つ目のタグにトリガーワードが配置されているでしょうか?容姿に関するタグはすべて除去できているでしょうか?間違ったタグは混入していませんか?ここの確認を怠ると、何時間もかけて失敗作ができるだけなので、入念にチェックしておきましょう。
<リピート数はどうする?>
さて、さきほどは説明を省きましたが、各フォルダ名の冒頭の数字、つまりリピート数はどのように考えたらよいでしょうか。結論から言うと、今回のミオリネスキームでは「miorine_rembranとbosarineは似てるけど別人だよ」という覚えさせ方をしていますので、それぞれのフォルダ内の繰り返し数は均等で構いません。
例えばmiorine_rembranを「6」、bosarineを「2」などにすれば、学習の重みに差をつけることができますが、そうすると制服ミオリネさんは正確に描けるけれども、ボサリネさんはいまいち学習が足りないというような現象が起こりますし、教師データ画像の枚数に大きな差がある場合以外、わざわざそのような差をつける必要は思い当たりません。「miorine_rembran,bosarine...」のように、それぞれのタグを併用して画像生成する場面が基本的に考えられない(※)からです。
※こちらのイラストのように3ylatermioとbosarineという本人同士のツーショットをどうしても描きたい場合はなくはないです。普通に生成しようとするとそれぞれの特徴が混じってしまうので、これは「RegionalPrompter」を使ったプロンプトの左右別適用で再現しました。
6.学習設定
最後に、Kohya Lora param GUIを起動して追加学習を行います。
パラメータ設定ですが、基本的には普通のキャラLoRAと同様の設定で構いません。今回はAnimagineXL3.1用のLoRAを作るので、Kohya Lora param GUIのプリセットで「Animagine汎用プリセット.xmlora」を選び、「batch1相当」の数字が2000~3000の間になるように調整すればOK。時間とVRAMに余裕のある方は、dimとalphaを増やすとより再現度が上がります。
特にキャラクターLoRAには「正解」がある(衣装の細部を少しでも間違えると生成失敗になる)ため、私は比較的高めの「dim64/alpha32」を好んで使っています。civitaiではdim128/alpha64で学習されたLoRAも見掛けますが、VRAM16GBのRTX4080で試そうとしたところ、VRAM不足でCuda out of memoryになってしまいました。
意図しない画風の変化を避けたい(キャラクター概念だけを学び、LoRA適用時もCheckpoint本来の画風で生成したい)ので、ベースモデルはAnimagineXLではなくこちらのLoRA学習用モデル「GenimagineXL」を指定すると良いです。学習データセットの画風に引っ張られず、自分の普段遣いしているモデルの画風でそのキャラを生成できるはずです。
今回の設定は以下の通り。dim8だと1時間程度、dim64だと2~3時間程度で学習することができました。
7.着せ替え可能な「マルゼンスキーム」のタグ付け
さきほどのフォルダ構成では、「miorine_rembran」タグを入れると、基本的に緑色の制服姿で描画されるLoRAにする構成になっていました。これは、5つの姿が髪型まで含めて大幅に見た目が変わるため、それぞれ「同一人物の別衣装」としてタギングするより、もはや別人物として学習させた方が効率がよいと考えたためです。
このやり方には2つデメリットがあって、1つは「miorine_rembranといえば緑のアスティカシア高専制服を着ている少女」という学習をしているため、別の衣装を着せたときになんとなくアスティカシア高専制服に似てしまうことがあるという点。もう一つは、別のキャラクターにこの衣装を着せようとしても、顔がミオリネさんになってしまう(衣装LoRAとしては使えない)ということです。
「miorine rembran」と衣装タグを自由に組み合わせることができ、かつ「asticassia school uniform」「bosarine」などと指示するとその通りの衣装になるLoRAにするには、さきほど少し触れたマルゼンスキームというタギング手法を使います。
★マルゼンスキームとは?
日本のウェブコミュニティでSD1.5時代(LoRA登場初期)に編み出された、スタンダードな着せ替えLoRAの作り方のこと。当時そのLoRAで再現されたキャラクターの名前を取って「マルゼンスキーム」と呼ばれています。
エヴァのアスカちゃんLoRAを例にとります。完成したLoRAで「1girl,souryuu asuka langley」を生成すると、ランダムな服装で描画され、プロンプト次第でどんな衣装でも影響なく着せられるアスカが出るのがまず最低条件。その上で、「red plugsuit」で旧型プラグスーツが、「test plugsuit」で新劇場版:破のテストプラグスーツが、「tokyo-3 middle school uniform」で第三新東京市の水色の制服が出るような学習をしたいとしましょう。
そうしたら、フォルダ構成は次のようになります。
LoRA/ ←ルートフォルダ(名前はなんでもよい)
└ training/ ←学習データを入れるフォルダ(名前はなんでもよい)
└ perfectasuka/ ←LoRAごとに作るフォルダ(名前はなんでもよい)
├ 4_souryuu_asuka_langley/ ←さまざまな服装のアスカの画像
├ 4_red_plugsuit/ ←旧型プラグスーツを着たアスカの画像のみ
├ 4_test_plugsuit/ ←テストプラグスーツを着たアスカの画像のみ
└ 4_tokyo-3 middle school uniform/ ←制服姿のアスカの画像のみ
タグ付けは次のようにします。
①4_souryuu_asuka_langley
トリガーワード:「souryuu_asuka_langley」
除去するタグ:「brown hair」「blue eyes」「small breasts」など、アスカの身体的特徴に関わるもののみ
除去しないタグ:衣装、ポーズ、背景などのその他タグ
②4_red_plugsuit
トリガーワード:「red_plugsuit」
除去するタグ:「souryuu_asuka_langley」(shikinami~など亜種が検出された場合も削除)と、旧型プラグスーツに関わる全てのタグ。
除去しないタグ:ポーズ、背景などのその他タグ
③4_test_plugsuit
トリガーワード:「test_plugsuit」
除去するタグ:「souryuu_asuka_langley」(shikinami~など亜種が検出された場合も削除)と、テストスーツに関わる全てのタグ。
除去しないタグ:ポーズ、背景などのその他タグ
④4_tokyo-3 middle school uniform
トリガーワード:「4_tokyo-3 middle school uniform」
除去するタグ:「souryuu_asuka_langley」(shikinami~など亜種が検出された場合も削除)と、第3新東京市立第壱中学校の制服に関わる全てのタグ。
除去しないタグ:ポーズ、背景などのその他タグ
このようにすると、アスカの純粋な身体的特徴のみが「souryuu_asuka_langley」に集約され、各コスチュームが衣装名のタグに集約されるわけです。できれば、各衣装のフォルダについては、アスカの首から上がフレームアウトするような加工を施しておくと、それらの衣装を他のキャラクターに着せ替えしやすくなります。
このLoRAを適用していれば…
・「souryuu_asuka_langley」=さまざまな服装で生成される
・「souryuu_asuka_langley,playboy bunny」=バニースーツが各衣装に引っ張られたデザインになりにくい(多少は赤っぽくなったりするかも)
・「souryuu_asuka_langley,test_plugsuit」=赤いテストスーツを着せられる
・「ayanami_rei,test_plugsuit」=綾波に赤いテストスーツを着せられる
こうした結果になるはずですね。もちろん、タグ付けをしても完璧に学習が除去できるわけではないので、データセットの内容によって多少はそれぞれの衣装に引っ張られる現象が起こります。その場合はNPに「test plugsuit」を入れるなどして調整することになります。
ミオリネスキームとマルゼンスキームとの違いを整理すると、次の通りです。
①ミオリネスキーム
容姿バリエーションがそれぞれ大きく姿が変わる場合、それぞれの容姿を再現しやすいが、LoRAに学習させていない衣装への着せ替えが難しくなる。衣装変化の柔軟度がやや低い代わりにデータセットも用意しやすい。リピート数も各フォルダ同じでよいので簡単。
②マルゼンスキーム
柔軟度が高く、衣装LoRAとしての側面も持つため、別のキャラクターにその衣装を着せることもできる。その代わり、キャラ名と衣装名のタグを混ぜて使うため、各フォルダの枚数がほとんど同じ場合は、リピート数を調整してバランスを取る必要があり、少し難しい。
8.できたLoRAで生成してみよう
さて、最後にミオリネスキーム(dim64)で作ったLoRAで生成テストをしてみましょう。まずは、1girl+トリガーワード+クォリティタグのみで生成したのがこちら。LoRAの適用強度は0.7です。
なんとなく顔周辺はよいようですが、服装の再現度は低いですね。これは容姿を覚えていないのではなく、衣装タグがないのでどういう衣装で生成すればよいのかモデル側が迷っている状態です。タガーで除去したタグをメモしておいたので、今度はキャラ再現用のトリガーワードとして使いましょう。
①トリガーワード:「miorine rembran」
再現補助タグ:「white hair」「green jacket」「seamed-legwear」「asticassia school uniform」など
②トリガーワード:「bosarine」
再現補助タグ:「messy hair」「tank top」「sad」など
除去しないタグ:ポーズ、背景などのその他タグ
③トリガーワード:「suitmio」
再現補助タグ:「black suit」「single hair bun」「wide-sleeves」など
④トリガーワード:「3ylatermio」
再現補助タグ:「short hair」「black jacket」「formal」など
⑤トリガーワード:「dressmio」
再現補助タグ:「earring」「blue dress」「single hair bun」など
生成結果がこちら。
※ちなみに、カンマで区切った複数のプロンプトを丸ごとXYZ plotでPromptS/Rしたいときは、かたまりごとにダブルクォーテーション「""」でくくればOKです。「","」の部分に半角スペースが入ると失敗するので気を付けましょう。
9.衣装デザインが混じってしまったら?
ランダム生成結果を見て気付くのは、それぞれの衣装デザインが一部「混じってしまう」現象が起きていることです。例えば、3年後ミオリネがドレスミオリネの青く長いピアスやスーツミオリネの黒ジャケットを着けた姿で生成されるケースがときどき発生します。
これは、スーツミオリネと3年後ミオリネがいずれも「black suit」と判定されるものを着ていたり、3年後ミオリネとドレスミオリネが「earrings」をしていたりしているため、異なるデザインがそれらのタグに重ねて覚えられているために起こる現象のようです。ベースモデルは「earringsはこういうもの」「black_jacketはこういうもの」と既に無数のデータセットで学習しているところに、新たに二種類のピアスのデザインが「earringsはこういう形」「black_jacketはこういう形」と重ねて学ばれてしまったということですね。
また、こちらの画像ではwhite shirtの襟部分も、一般的なワイシャツの襟と学習したもののどちらで描いたらよいか決めかねているように見えます。
つまり、ベースモデル上で既に学習している概念と重なる別々の概念を学習する場合、概念の混在が免れないということでもあります。これを回避するのはなかなか大変ですが、suitmioを生成したいときはdressmioをネガティブに入れたり、再現したいものの色や形状などをタグ指定することで打率を上げる(誤解を避ける)、トリガーワードを強調するーといった方法が考えられます。
<実験>「3ylatermioがdressmioのイヤリングをしてしまう画像」に、次の三つの条件変更をして結果を確かめる
(1)dressmioをネガティブに入れた場合
(2)blue long earringsをネガティブに入れ、silver stads earringsをポジティブに入れた場合
(3)(3ylatermio:1.2)とトリガーワードを強調した場合
結果、やはりプロンプティングによって「青い長いイヤリングはやめてね」「銀色のスタッズピアス(stud earrings)にしてね」と丁寧に指示するのが一番よいようです。ワイシャツの襟部分は「collared shirt」をネガティブに入れれば、学習したものに寄せることができました。
完全に描き分けたい場合は、それぞれの衣装部位に個々のトリガーワードを付けて学習させるといったこともできるかと思いますが、あまりに手間ですので、こうした対症療法くらいしか今のところ思いつきません。良いアイデアがある方はぜひコメント等でお寄せ頂けると嬉しいです。
ちなみに、今回はAnimagineXLで作りましたが、同じデータセット・同じタギングのままPonyDiffusion v6で学習させたところ、次のような学習結果になりました。タギングはe621形式ではなく、御覧の通りdanbooru形式で行っています。Pony系のLoRA学習については、もう少し知見がたまったら記事にまとめたいと思っています。
10.終わりに -「作品LoRA」もできる?-
コンパクトにまとめるつもりがずいぶん長くなってしまいました。今回紹介したミオリネスキームは、5人の別キャラクターを1つのLoRAで再現する手法ですので、そもそも別の5人を1つのLoRAで再現する「作品LoRA」を作ることも可能です。
例えばCivitai上には「ガールズバンドクライ」の主要キャラクター(トゲナシトゲアリメンバー)5人の容姿をいっぺんに追加学習させ、別々のトリガーワードで再現できるLoRAが配布されており、これはまさにミオリネスキームと同じやり方で作っているようです。
NovelAIでは、1girlのあとに各キャラクター名のタグと作品名を入れる(例:1girl,miorine_rembran,gundam_suisei_no_majo)と、そのキャラクターが高精度で再現される傾向にあります。これは、NovelAIv3がその作品を描いた多くの画像データセットに、個別のキャラタグを付して学習していることを示していますが、これと同じことを追加学習(LoRA)でやるのが「作品LoRA」ということですね。
個別に5人分のキャラLoRAを作って「同時に適用する」「LoRA同士をマージする」やり方でも同じ結果になるのかは未検証ですが、その場合起こりうるのは今回起きた「キャラ間で似た要素が混じる」現象。特に、複数キャラを1枚のキャンバスに生成する場合はなかなか難しいのではないかと想像しており、その場合は複数キャラが同時に映っている画像を教師データとして多く学ばせる必要があるかと思います。
ハイクォリティなスレミオイラストを作りたい場合は、スレッタLoRAとミオリネLoRAがあればいいだけでなく、2人が同時に映った画像もたくさん盛り込んだ「スレミオLoRA」を学習させるとよいのではないかと考えているので、いずれ検証結果をご報告できればと思います。(Regional Prompterやインペイント合成でもできるんですけどね)
それでは今日はこのへんで。スタジオ真榊でした。
※「作品LoRA」の作り方と複数キャラの同時生成の方法については、こちらの記事で検証しています。
Files