Home

 Creators
 Search
 Recent
 Random
 Posts
 DMs
 Tags
 Random
 Importer
 Import
 FAQ
 Account
 Register
 Login
 Favorites
 Keys
 Logout
 Telegram

1枚の絵から「別カット」を量産してキャラクターLoRAを作る(for illustrious) (Pixiv Fanbox)
Content
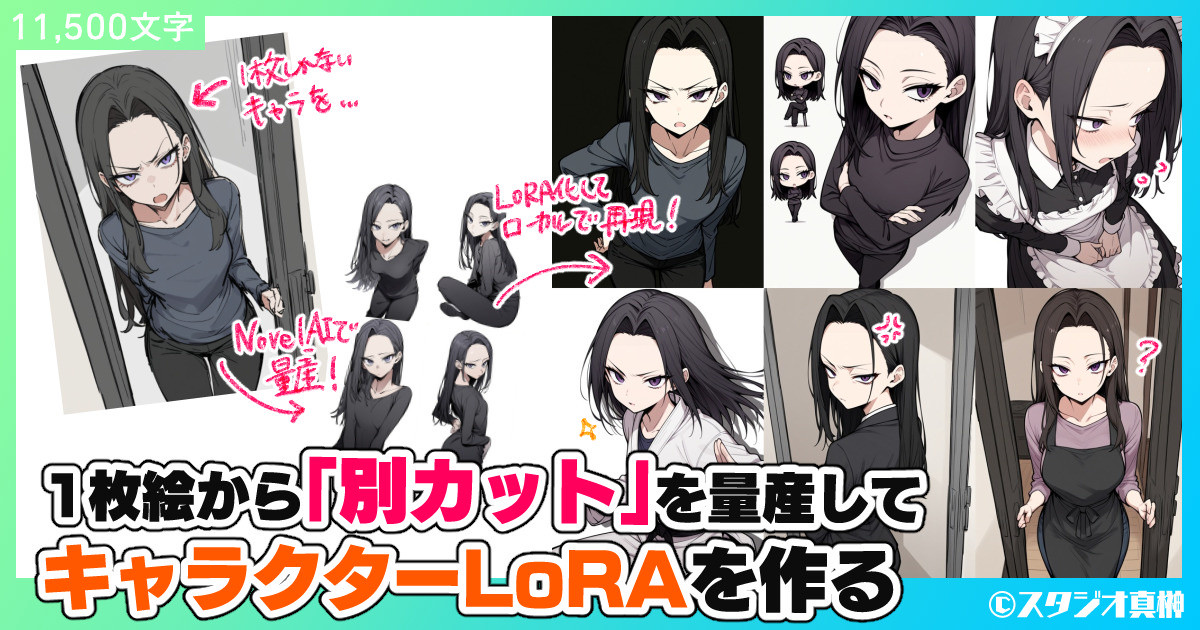
こんばんは、スタジオ真榊です。今回は2025年5月現在の環境におけるキャラクターLoRA作りの検証記事をお届けします。具体的には、NovelAI v4の新機能「ポーション」と「ランダムプロンプト」をうまく使うことで、手元に1枚しかないキャラクターの絵を基に構図やポーズの違う「別カット」を低コストで量産し、それらでキャラLoRAを作って恒久的に再現できるようにする手法について特集しました。
NovelAIの性能を活かした「同キャラ別カット」については、ちょうど1年前にこちらの記事でも特集したことがあります。こちらは「AIは同じキャンバス上でインペイントするとき、キャラクターの容姿をできるだけ保持しようとする」性質を利用したものでしたが、V4を使った今回の手法ではさらに簡単かつ低コストでオリジナルキャラクターLoRAを作れることが分かりました。
検証の題材にしたのは、かなり前に偶然生成したこちらの絵。この1枚を基に、このキャラデザや雰囲気を「現在使っているillustrious系モデルの画風で」再現できるLoRAを作れるか試してみました。こちらのイラストはラフスケッチ風ですが、強制的にラフスケッチ風になってしまうLoRAでは使いづらいので、あくまでillustrious系モデルで汎用的にキャラデザを再現できることを目的にしています。
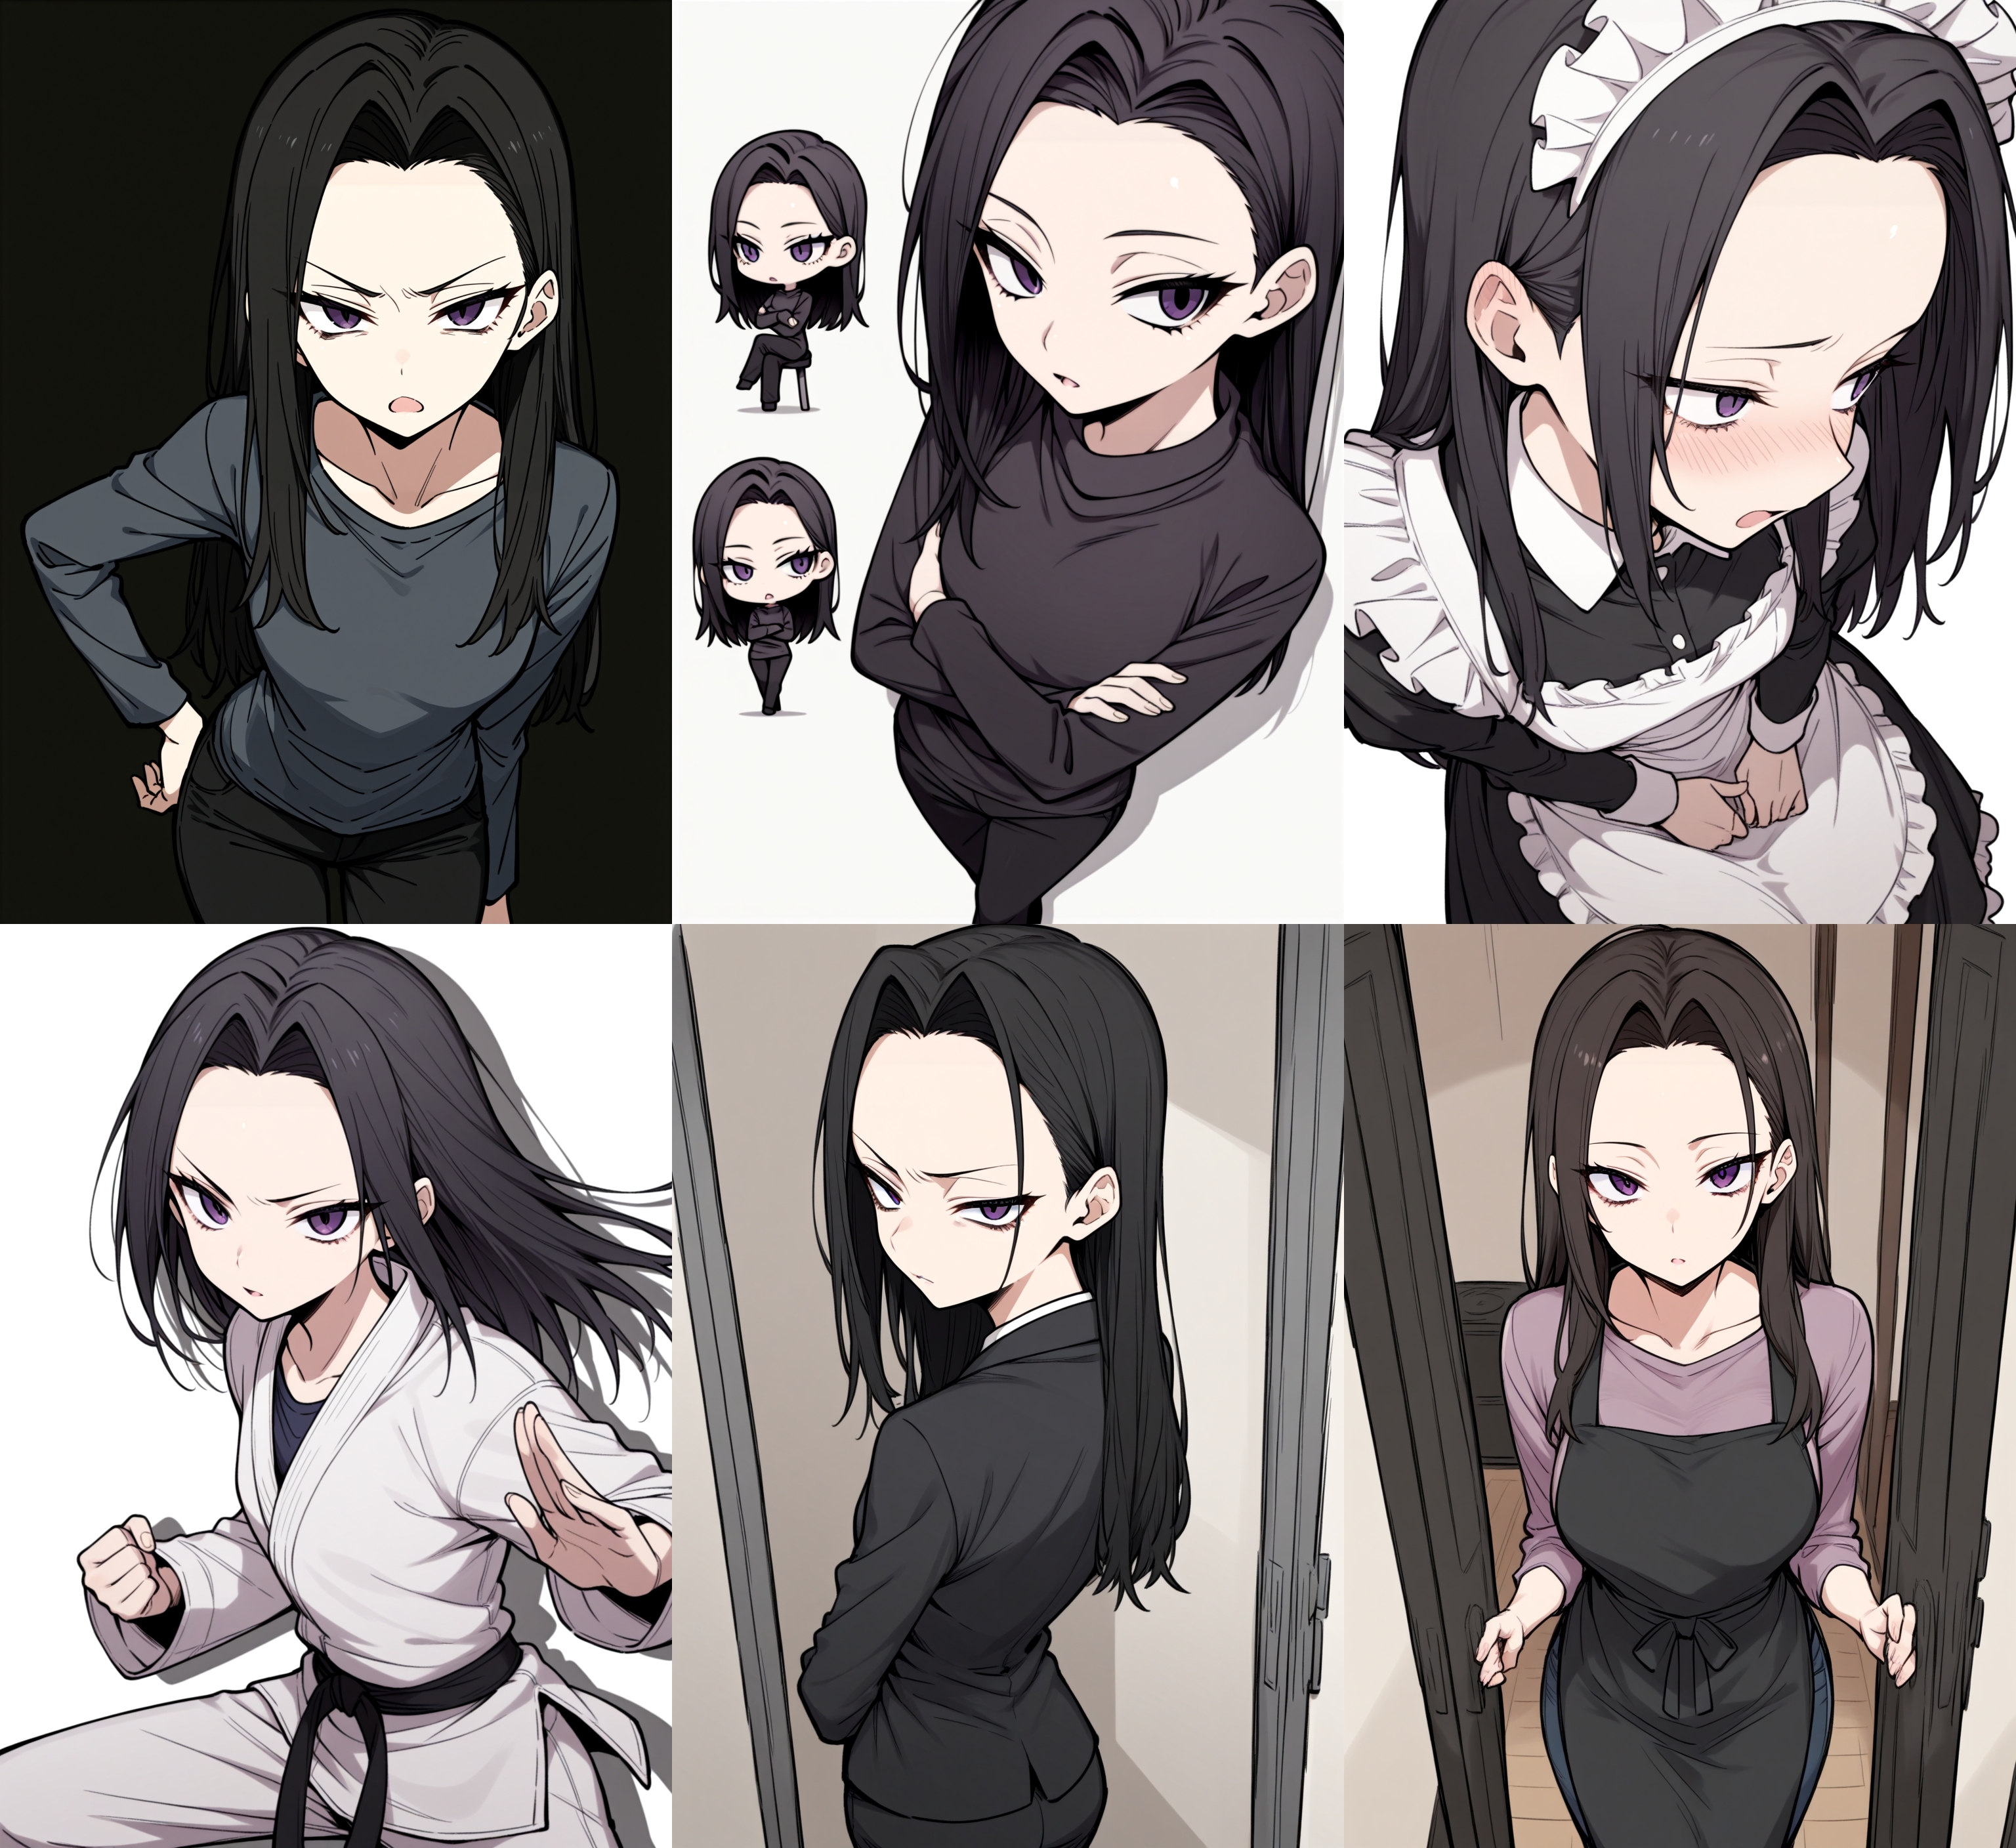
こちらができたLoRAで生成した画像です。現在のモデルの画風を壊さずに、キャラクターデザインや雰囲気をうまく抽出できており、服装なども自由に変えられるLoRAになったかと思います。
1枚絵さえあればそのキャラを一貫性を持って再現できるようになると、AIイラストだけでなく、オリジナルの漫画や映像作品を作る上で非常に役立ちます。LoRAの学習時間を除けば30分程度の作業時間でできるので、漫画作りをする前に一手間掛けておくと非常に捗るはず。特に、0Anlasで通常サイズの1枚生成ができる「Opus」プランの方はほとんどAnlasを消費せずにデータセットが作れますので、ぜひトライしてみてください。
目次
NovelAI v4の「ポーション機能」
・抽出度×適用強度=調合
・ポーションを使ったキャラクター再現のやり方
・生成結果
・ポーションは「万能薬」ではない
・量産したポーション画像でLoRAを作ろう
新機能「プロンプト抽選機」
LLMで「全身立ち絵」も作る
LoRA学習用のデータセットを作る
・普段のモデルで画風統一してみよう
完成したデータセットでLoRAを作ろう
・「縮小革命」で画像サイズをそろえる
・タギングする
・学習開始
生成テスト
・反省ポイントも…
・ミスを修正しよう
・なぜ、見下ろしで遠近強調の画像ばかり出るのか
終わりに - できたLoRAで動画作品を作ろう!
NovelAI v4の「ポーション機能」
今回の手法でメインに使うのは、2025年4月14日に公開されたNovelAI v4の新機能「ポーション」です。
「ポーション」は、好きな画像(1〜16枚)から画風・配色・構図の「エッセンス」を抽出し、生成時にブレンドできる機能です。要するに、V3にあった「バイブストランスファー」機能の強化版で、使い方もほとんど同じ。性能と使いやすさは以前よりも大きく向上しており、原理は異なりますが、NovelAIにおける「簡易的な追加学習機能」と感じるくらいです。
・抽出度×適用強度=調合
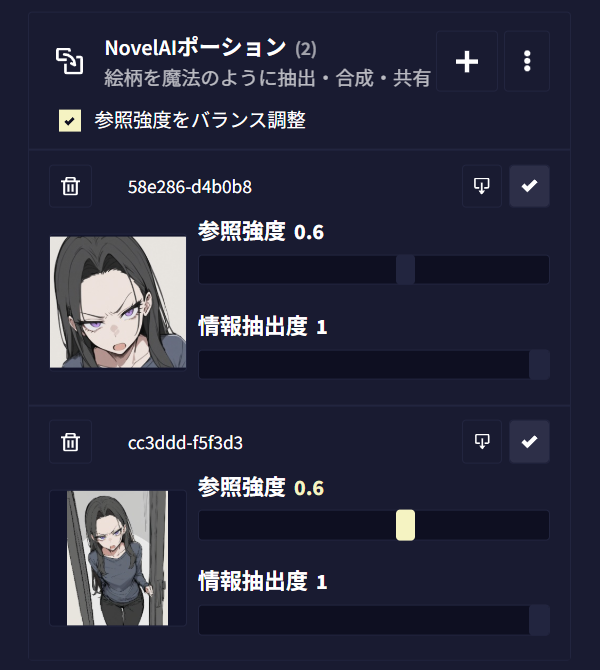
バイブストランスファーと同様、ポーションでも「抽出度」と「適用強度」というパラメータを参照画像ごとに指定できます。
参照強度:生成画像にポーションの影響をどれだけ反映するか。複数枚を参照させる場合、合計1.0以下が推奨。
情報抽出度:0.1寄りだと構図優先、1.0寄りだと画風・質感優先になる。数値を変更すると再調合が必要で、Anlasが微妙に消費される。
ポーションは複数の画像でこれらのパラメータを組み合わせてバランスを作ることを前提としており、そうした行為を「調合」と呼びます。
最初にポーションを「調合」するときは2Anlasを消費しますが、一回調合するとそのレシピを記憶させた「naiv4vibe」ファイルというものを保存でき、次から調合料金が掛からなくなります。3点リーダボタンから「ポーションセットファイルを保存」すると、ローカルに「2025-05-XX.naiv4vibebundle」といったファイルを保存できるので、次回からこれを読み込むとAnlasを節約できます。また、4つ以上の参照画像をポーションにする場合、追加画像1枚ごとに2Anlasの費用が追加されます。
文章で読んでも分かりにくいので、実際にやってみましょう。
・ポーションを使ったキャラクター再現のやり方
今回はさきほどのオリジナルキャラクター・鬼怒川あんなさん(29歳既婚・元パンクロッカー)の1枚絵をポーションにして、構図やポーズの違うあんなさんを生成してみます。参照画像が一枚しかないと印象が薄いので、このように顔のアップ画像もスクリーンショットで作り、計2枚読み込ませました。
参照強度はそれぞれ初期値の「0.6」のまま。情報抽出度も初期値の「1」のままです。NAI公式によると参照強度は総計「1」になるよう調整したほうがよい(この場合0.5+0.5)とのことですが、やってみたら特に問題なかったのでこのままの調合で行ってみます。
プロンプトは、参照させるあんなさんの画像を生成したときとほぼ同じ(下図)。これで生成すると、参照画像に似たテイストのキャラクターが生成できるはずですね。
今は1枚しかあんなさんの画像が手元にありませんが、ポーションで良いものができたら、新たな参照画像として調合に加えたいので、「白背景(white background,simple background)」かつ「複数角度(multiple views)、横から(from side)、背後から(from behind)」と設定しました。
このようなマルチビュープロンプトを使って横長のキャンバスで生成すると、基本的に同じキャラを複数の角度から描いたものが出てきやすいことがよく知られています。(ちなみに、「smile,angry,sad」など互いに反する表情を入力すると、表情集のようになることがあって面白いです)
・生成結果
さて、こちらが一発目の生成結果です。いきなりかなり似てくれて驚きますね。横長の大キャンバスにすると1枚30Anlasかかるかわりに、1枚の生成で3回生成チャレンジができてオトクです。
参照強度を ちょっと強めるとこんな感じになりました。新たなポーションとして追加したいので最初だけAnlasを奮発してみます。
何度か回すとこちらの画像が出てきました。イメージにそっくり!せっかくなので、左右を別の画像として切り出して、新しいポーションとして加えました。
・ポーションは「万能薬」ではない
このように、ポーションをうまく使うと気軽に特定キャラクターの1枚絵を量産することができます。マイナーなアニメキャラを生成するときなどに向いているかなと思いますが、現在TLをにぎわせている最新アニメのエースパイロット人妻キャラを再現しようとしたところ、さほどうまくいきませんでした。
このキャラクターは白目が肌色で描かれるなど、かなり通常のAI絵の画風とはかけ離れた、特徴的な画風のキャラクターです。ポーションは非常に便利な機能ですが、キャラデザというより「画風」のレベルで強い特徴を持ったキャラクター(特に、クレヨンしんちゃんやドラえもんのような骨格からかけ離れたキャラクター)となると、うまく似せられないようです。
こうした難しい生成になると、Gemini 2.0 Flash Experimentalのほうががぜん得意です(ChatGPT4oはGPT画風に変更してしまうのでやや不得意)。アップスケールの必要はありますが、ポーションだけが「別カット」の選択肢ではないことは覚えておきましょう。
「ポーションよりGeminiのほうがいいじゃないか?タダだし」となりそうですが、Geminiは細部の描写がいまいち甘く、アップスケールも気軽にできないのが玉にキズ。それぞれ一長一短があるので、場合によって使い分けるのがオススメです。
・量産したポーション画像でLoRAを作ろう
さて、今回の目的は、あんなさんの特徴をよく捉えた一貫性のある画像を、ある程度のバリエーションを持って15枚前後用意し、LoRAを作ることです。普段使いのモデルで違和感なく生成できるように、画風には極力影響しないLoRAにしたいところですね。
ポーション用参照画像が揃い、安定してあんなさんの画像が生成できるようになりましたので、今度はキャンバスサイズを「普通」に変更します。Opusプランなら0Anlasで生成し放題なので、NovelAI v4のもう一つの新機能「プロンプト抽選機」を使って、Anlasを節約しながらデータセットを作っていきましょう。(※ポーション枚数が4枚以上になると、わずかに追加Anlasがかかります。できれば3枚までにとどめたいところですね)
新機能「プロンプト抽選機」
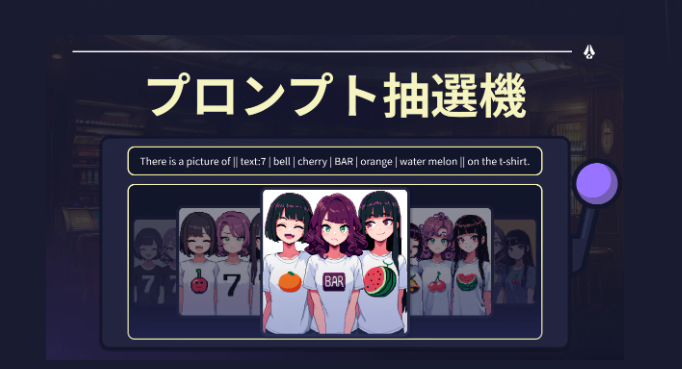
さて、ポーション機能搭載の少し前、2025年4月9日に追加されたもう一つの新機能が「プロンプト抽選機」です。LoRA用データセットを用意するのに、こちらの機能を使ってみます。
StableDiffusionでは、半角の{}でくくった内部を半角縦棒「|」で複数分割することでプロンプトを抽選できる「Dynamic prompt」機能がよく知られています。
一方、NovelAIでは{}の代わりに半角縦棒2本「||」と1本「|」でくくるルールになっています。縦棒は「Shift + ¥ キー」で出てきますが、SDのDynamicPromptに慣れていると本当に{}と打ち間違えやすいので、注意しましょう…。
さて、今回の検証ではこの機能を使って、あんなさんのさまざまなポーズ・画角を生成してみたいと思います。正面立ち絵ばかりだと、汎用性のないLoRAになってしまうためですね。
今回はこのようなランダムプロンプトを組みました。
ポーズ:||sitting|standing|dancing||
表情:||smile|angry|sad|expressionless||,detailed eyes,||cowboy shot|full body|upper body|face||
画角:||from side|straight on|from behind||
服装:||skinny nipples,completely nude|casual wear,long sleeves||
completely nudeを入れたのは、LoRA性能を上げるため、着衣画像だけでなく裸の画像もある程度あったほうが良いためです。LoRAを使ってH画像も生成したいならなおさら、脱いだときの体の特徴は覚えさせておきたいところですね。服装は決まったメイン衣装があるならそれだけでも良いですし、あまり偏るのが嫌なら色んな服装が出るプロンプトにするとよいでしょう。
<以下、裸の画像が一部混じるため改めてご注意ください>
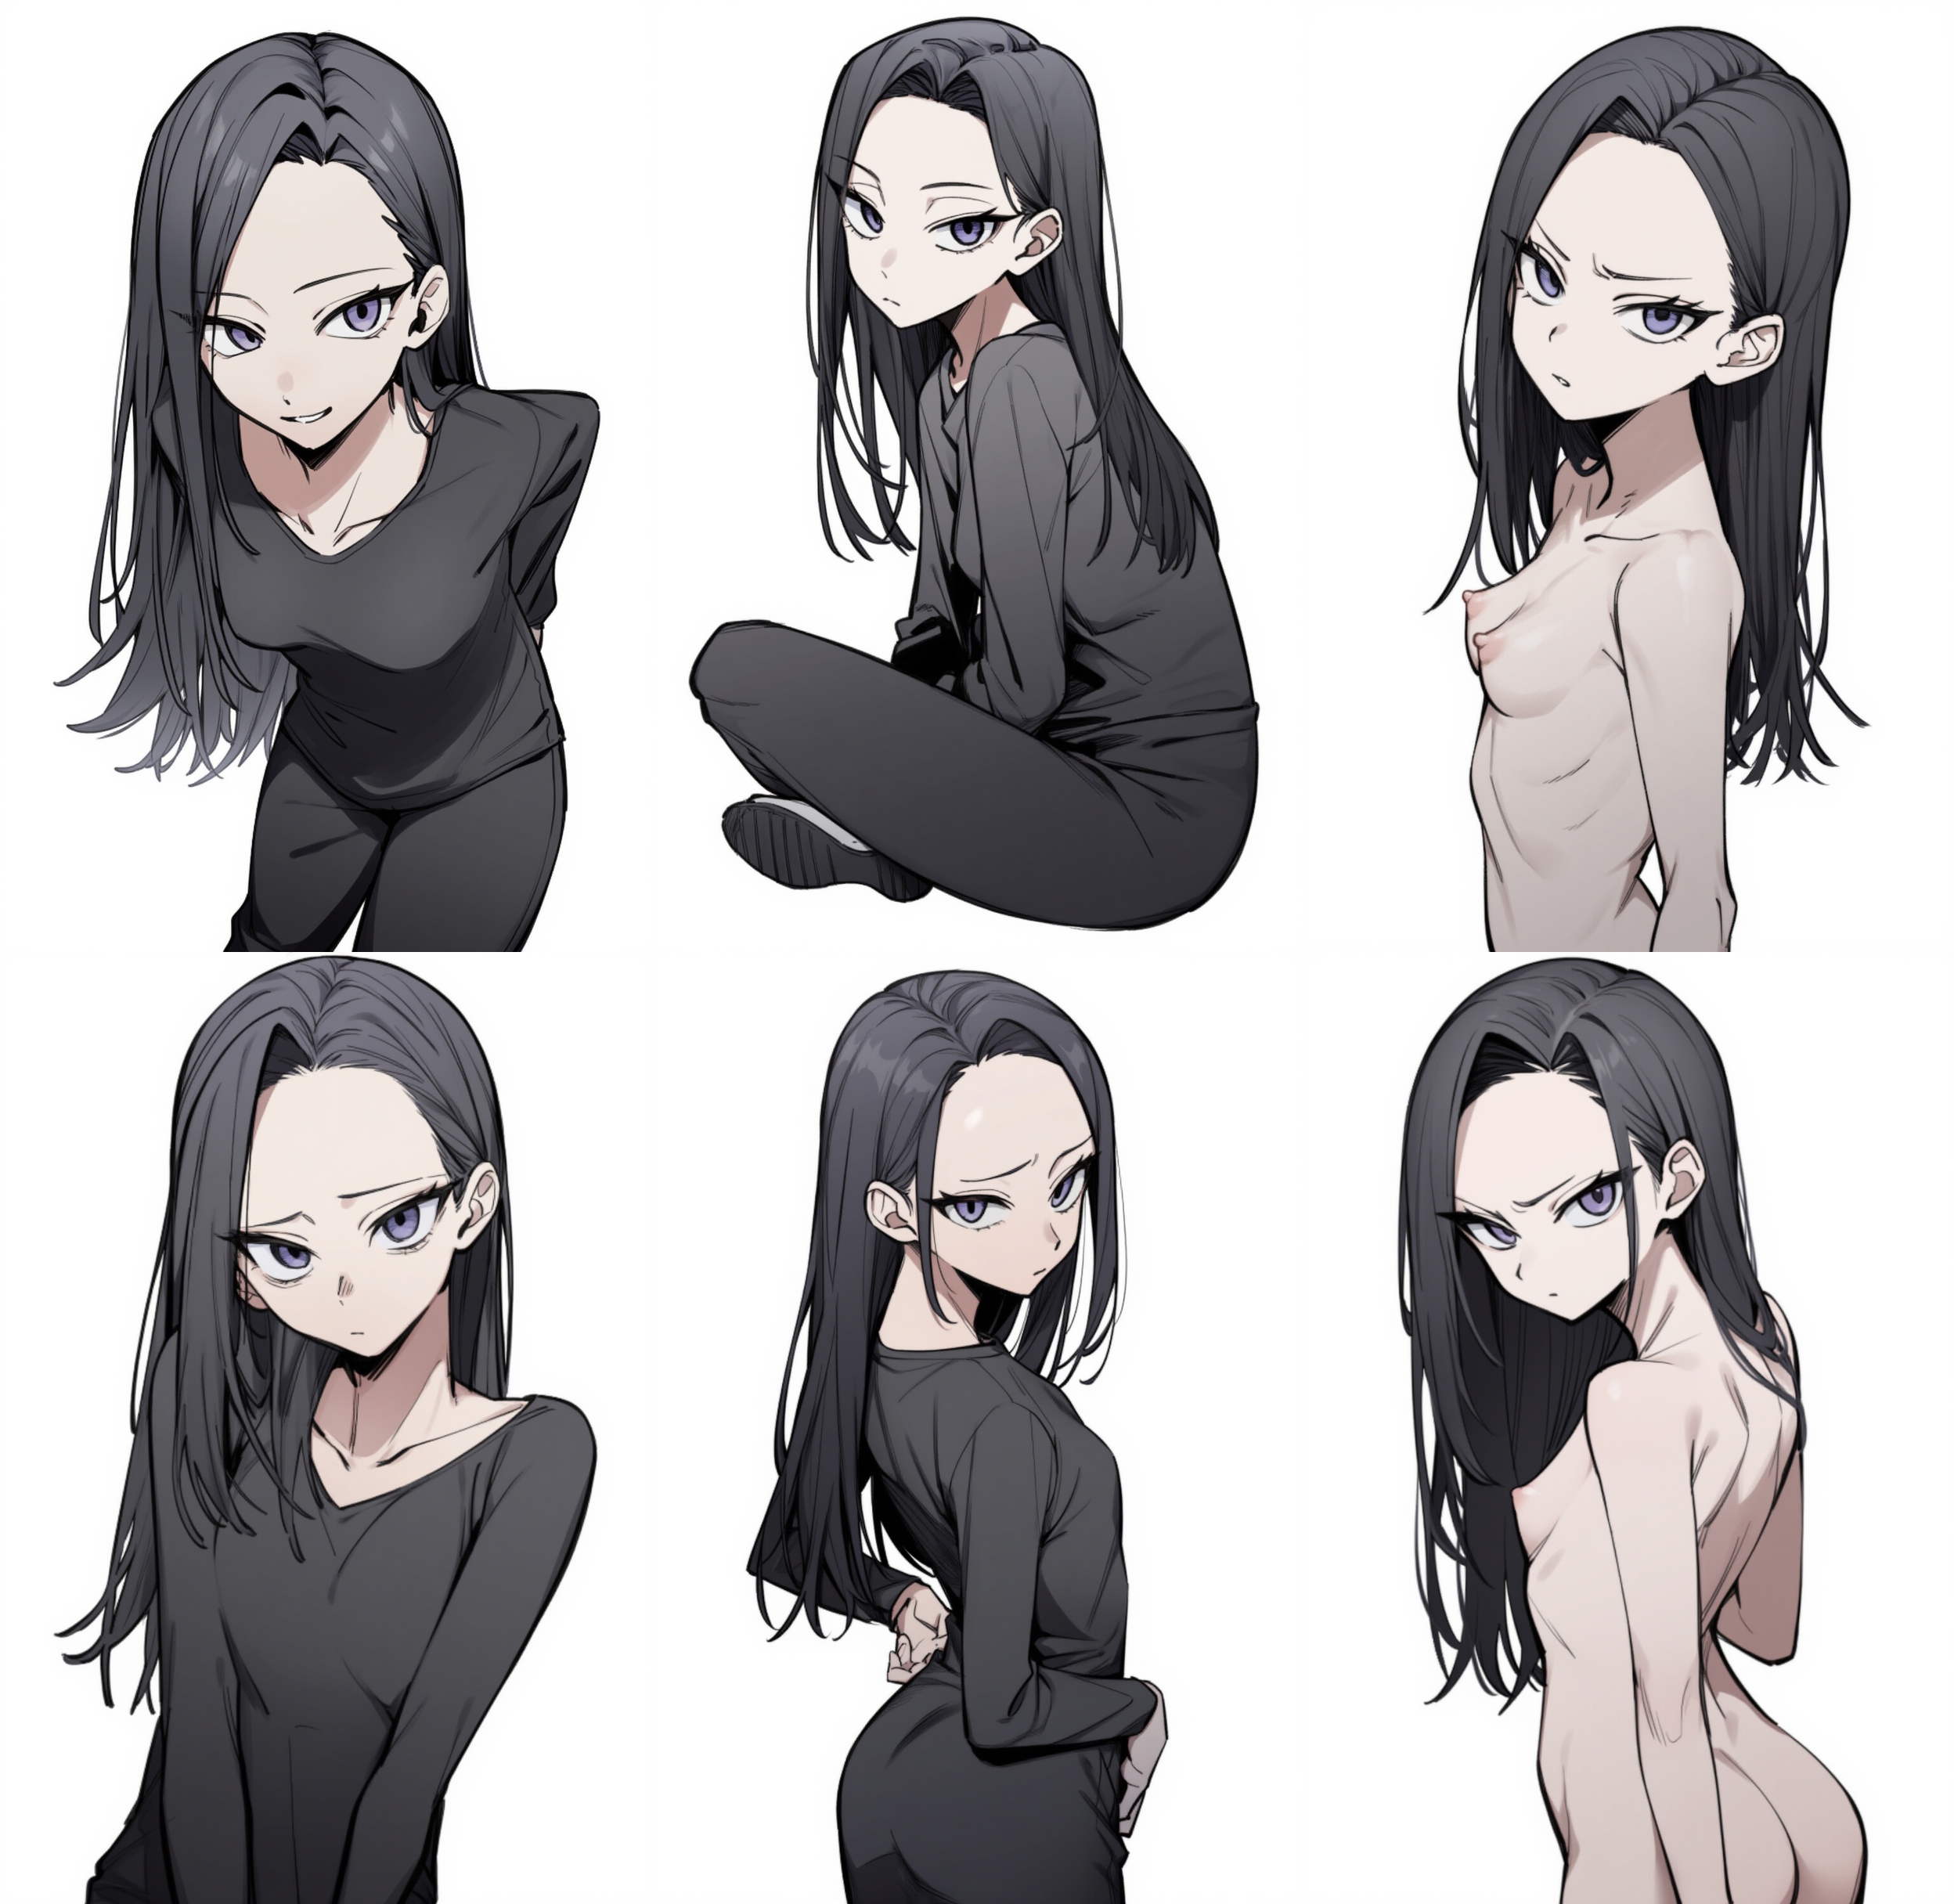
こちらが、ポーション機能+ランダムプロンプトで出てきた画像の例です。キャラクターの特徴を捉えているものもあれば、ちょっと違うな?と思うものもあります。ここは数値化できない美術的感覚の話になるのですが、あまり難しいことは考えず、たくさん出てきたものの中から「あんなさんだな」と思える画像をバランスよくピックして15枚そろえることにします。
LLMで「全身立ち絵」も作る
さて、ここで少し脱線。裸の画像を混ぜるとLoRA性能がよくなるのと同じように、アップの画像ばかりでは引きの絵が出にくいLoRAになるので、全身の立ち絵も混ぜたいところです。
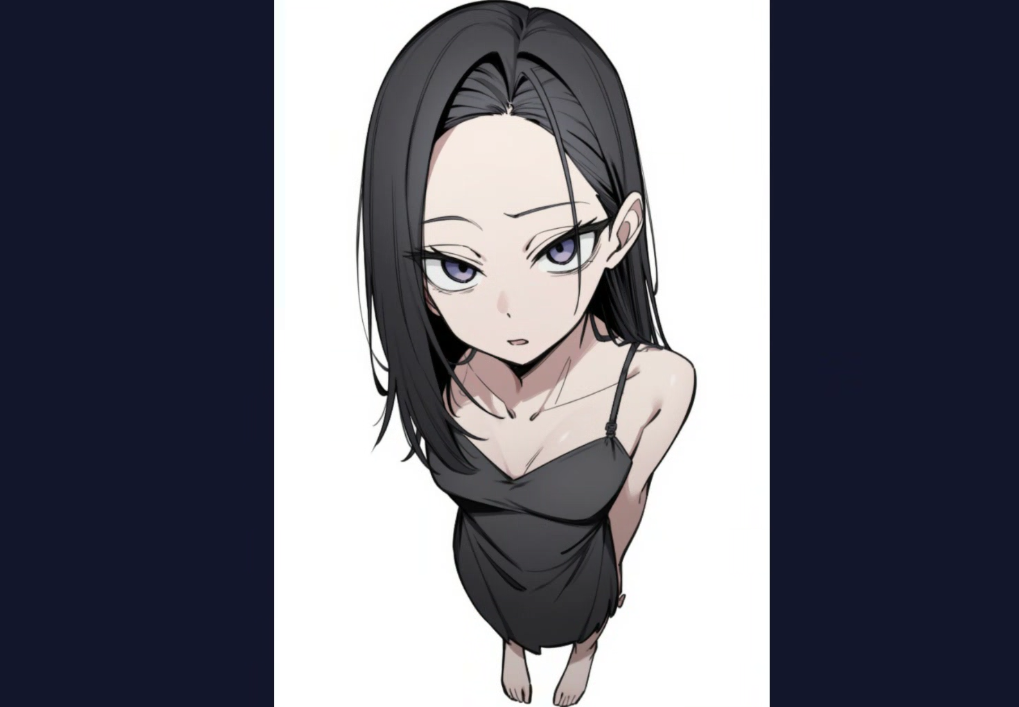
ポーションでfull body,standing,barefootなどと指示しても出るのですが、ポーション画像の構図の影響を受けて、このように遠近法の効いたものが出やすくなっています。これでLoRAを作ると、このようにいつも顔は大きく、足元が小さく描かれるLoRAになってしまう恐れがあるわけですね。
from above(頭上からの画角)やforeshortening(短縮遠近法)をネガティブに入れても、なかなかうまくできません。本当にほしいのは、下図のように真横から全身を捉えた、キャラクターの頭身や体つきがよく分かる画像です。
そこで、LLMに頼んで正面・横の立ち絵を生成してもらうやり方を考案しました。さきほど人妻パイロットのくだりでも触れたとおり、ChatGPT4oは画風をあまり保持してくれないので、ここはGemini 2.0 Flash Experimentalに頼んでみます。(Geminiの使い方についてはこちらの記事参照のこと)
このような感じでお願いすると…
「まさに」というものがあっという間にできました。こういう単純なようで複雑なお願いごとを聞いてくれるのは本当にLLMさまさまですね。
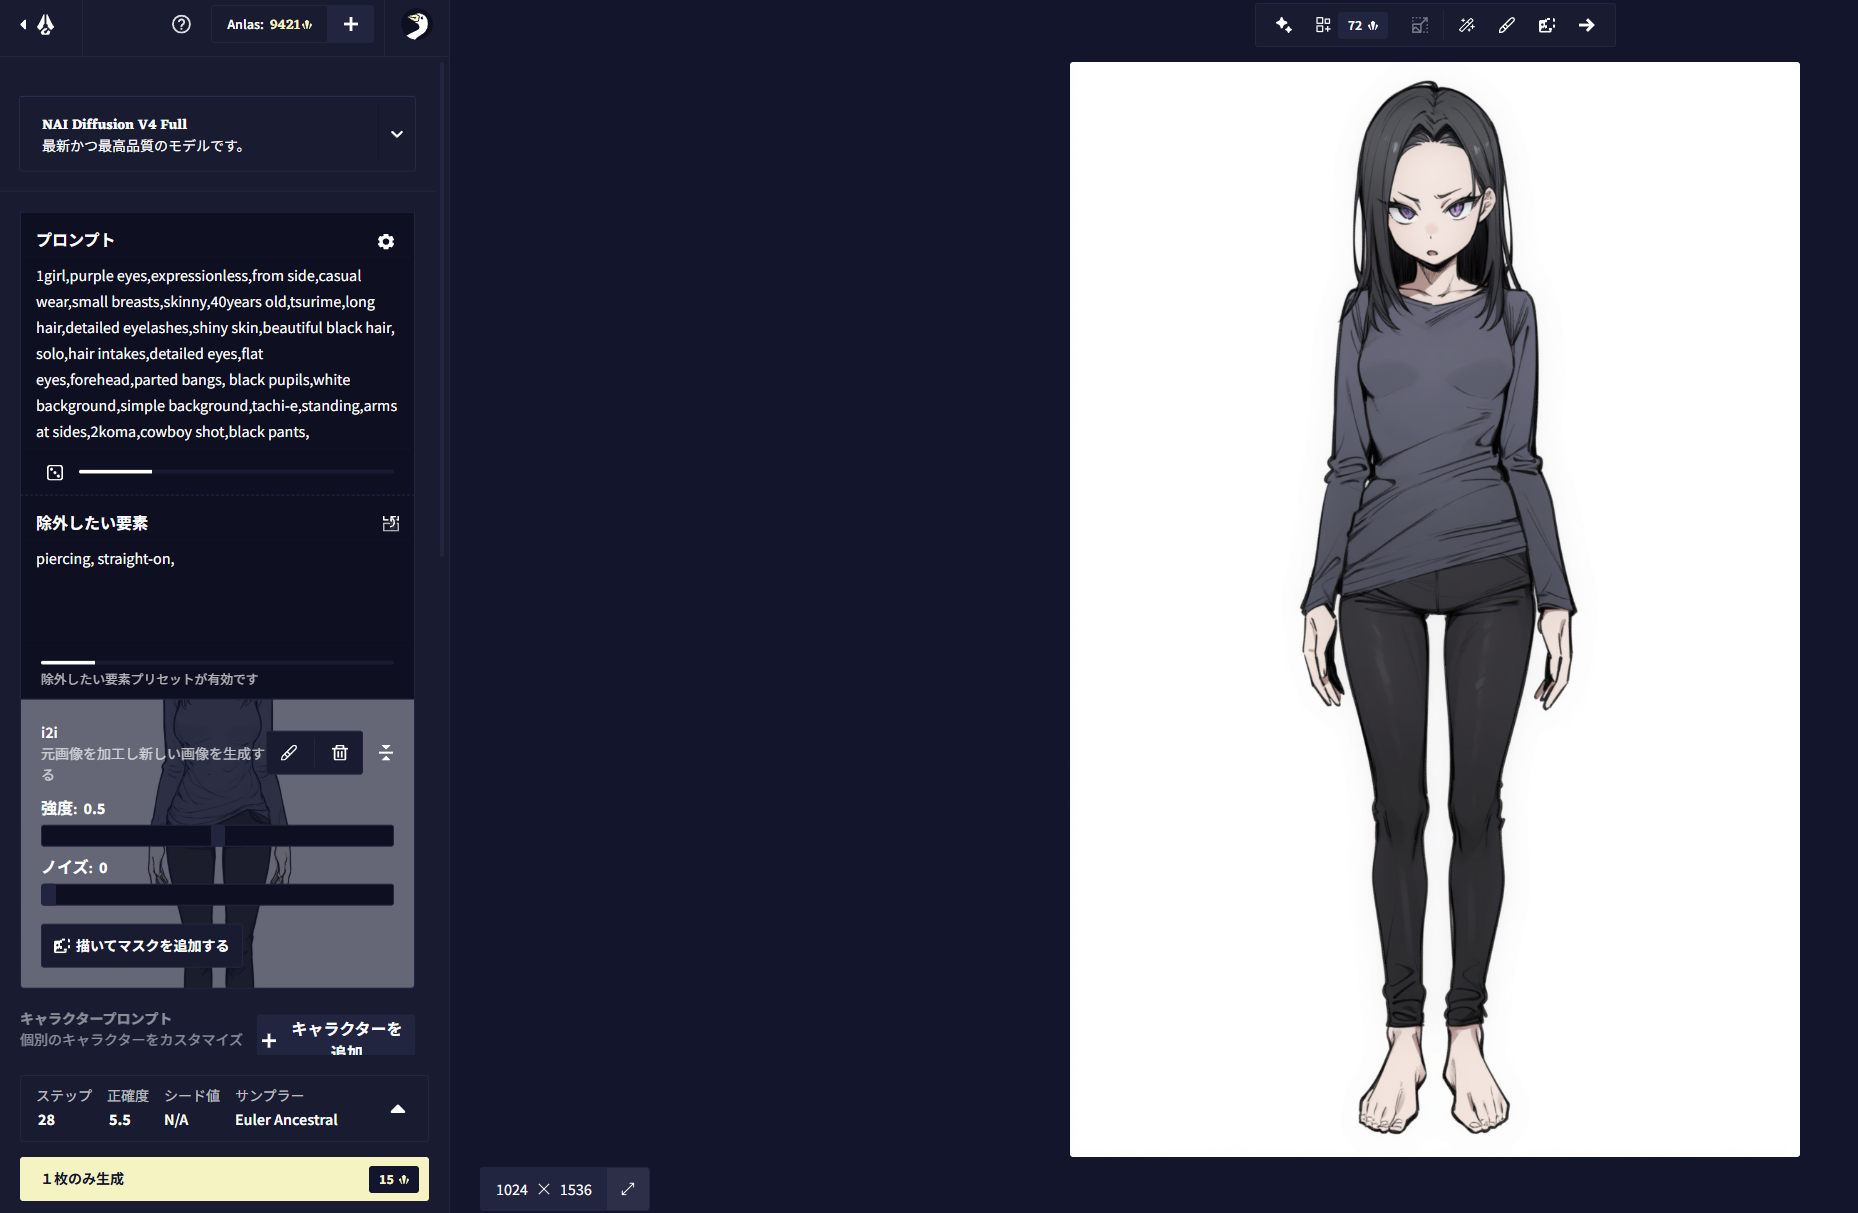
ただ、Geminiの生成画像はアップにすると画質が低く、ChatGPT4oに比べれば一貫性があるとはいえ顔もそこまで似ていません。せっかくあんなちゃんを生成できるポーション機能が整っているところですので、ポーション機能を使ったimage2imageで似せることにします。(画質が気になるようなら30Anlas払って「大」サイズで生成してもよいです)
このように、強度0.5以上で生成すればOK。「フォーカスインペイント」を使って顔だけアップスケールを計りたいところですが、ポーション機能はまだインペイントに対応していませんでした。
もっと詳しく設定したい場合は、同じように、横からのカットや背後からのカットを加えてもよいでしょう。裸のバージョンも用意すると、胸の大きさなどを強調できるかと思います。
LoRA学習用のデータセットを作る
ポーション画像は3枚までなら2回目から普通サイズ生成がタダになるので(※Opusプランのみ)、あとは15枚前後、いい感じの画像が出るまで回します。NovelAIの生成履歴はふとしたこと(ブラウザバックなど)で消えてしまうことがあるので、いったん右下の「一括で圧縮保存」で全部zip保存しておきましょう。
新規フォルダを作り、生成結果の中から15枚前後厳選していきます。あまり笑顔にならないクールでフキゲンなキャラにしたかったのでこういうバリエーションになりましたが、表情豊かなキャラクターならもっと笑顔や泣き顔なども取り交ぜると良いでしょう。背景は白統一でも良いですが、何枚かは背景があるものを混ぜたほうがよいかも。
・普段のモデルで画風統一してみよう
ここでいったん頭の体操です。
「これからつくるLoRAで学びたいのはキャラデザでしょうか?画風でしょうか?それともその両方でしょうか?」
例えば、ドラゴンボールの悟空のキャラデザを公式画像だけで学ぶと、鳥山明先生由来の画風込みで悟空が学べてしまい、普段使いのモデルで生成しても「鳥山先生風の悟空」になるわけです。今回学習したいのは、どんなモデルに適用しても「あくまで適用したモデルの画風で」あんなさんが生成できるキャラLoRAである、ということを再確認します。言ってみれば、ジャンプ作家がそれぞれの画風で描いたDBのファンイラストのようなイメージで、柔軟性を持ったLoRAにしたいわけです。
できるだけ統一感のあるデータセットにしたとはいえ、NovelAIで出したデータセットの画風(塗りや線画のテイスト)には多少のブレがあります。これから追加学習するLoRAでは、普段使いのillustrious系モデルで、いつもの画風でそのキャラを生成したいわけですから、覚えたいのは「画風抜きのキャラデザ」。そこで、さきほどのデータセットを全て、普段使いのモデルの画風に統一する作業を挟んでみます。
やり方は簡単。reForgeなどローカルwebUIで、image2imageの画面を開き、こちらの「バッチ」モードでさきほどのデータセットのフォルダをフルパス指定します。同じフォルダに出力すると混じってしまうので、末尾に「2」と付けるなどしておけば、同じ階層に別フォルダが自動生成され、そこに「普段使いモデル画風」のデータセットが出力されます。
生成設定は「ご自由に」なのですが、あまり変容させるとここまで手を掛けて一貫性のあるデータセットを組んだ意味が雲散霧消してしまうので、ノイズ除去強度を弱くするか、Controlnet「Anytestv3」などを使って、線画をそのまま継承することをおすすめします。あくまで「品質を底上げしつつ塗りを普段遣いのモデルに近づける」程度の感覚で、そこまで画風が変容しすぎないようimage2imageアップスケールすると良いでしょう。
完成したデータセットでLoRAを作ろう
ここからの作業は、これまでとりあげてきたLoRA学習のやり方と変わりません。詳しくはこちらの二つの記事で解説していますが、タガーを使って自動タグ付け(タギング)したら、「Kohya lora param gui」を起動して、高速オプティマイザ「CAME」を使って学習していきます。
・「縮小革命」で画像サイズをそろえる
ここで注意。学習を始める前に、データセットの画像サイズを短辺1024px程度にそろえることを忘れないようにしましょう。※illustriousはもっと大きい画像でも学習できるようですが、通常のSDXLモデルと同様1024pxで問題ありません
image2imageアップスケールを挟んだ場合、手元のデータセットの画像はサイズがかなり大きめになっていると思います。上の記事で解説したのと同様、「縮小革命」というフリーソフトで一括縮小しておくとよいでしょう。下図のように「1024x〇〇」を選び、「短辺基準」「回転なし」「PNG」としておき、右下に画像ファイルを複数選択してドラッグ&ドロップすると、「保存場所」で指定した場所に指定通りのサイズに変更された画像がドッと生成されます。
「Resizedの中に保存」にチェックを入れておけば、ファイル名の頭に「s-」がついた画像がResizedフォルダ内に一括生成される仕組みです。
(※縦横比のタブで"アスペクト比調整を有効にする"にチェックが入っていないことを確認しましょう。チェックされていると画像がトリミングされてしまいます)
・タギングする
サイズがそろったら、データセットの画像からタグを抽出します。下図のように、画像を収めているフォルダのフルパスを入れればOK。トリガーワードはキャラ名の「anna_kinugawa」とし、覚えてほしい容姿のタグを抜いていきます。
例えば「black hair」「forehead」「purple eyes」などがそうですね。ポイントは「anna_kinugawaを構成する要素は消す」「anna_kinugawaがどんな状況で何をしているところかだけを残す」イメージ。単にタグ名をクリックしていくだけで、隣の「Keep tag」の欄に自動入力されますので、最後に除外タグ(Exclude Tags)の欄にまるっとカットアンドペーストするのがおすすめです。1girlとsoloは残すこと!
<ここで、私は「常に額が出ているキャラデザだからforeheadを消そう」と決めるのですが、のちにミスと分かります。とりあえずそのまま読み進めてください>
タギングができると、このような感じでフォルダにテキストファイルが並びます。
「anna_kinugawa, 1girl, solo, looking at viewer, white background, simple background, upper body, black shirt, closed mouth, long sleeves, expressionless」などとなっていればOK。「鬼怒川あんな」を構成する要素が残っていたらちゃんと消しましょう。
・学習開始
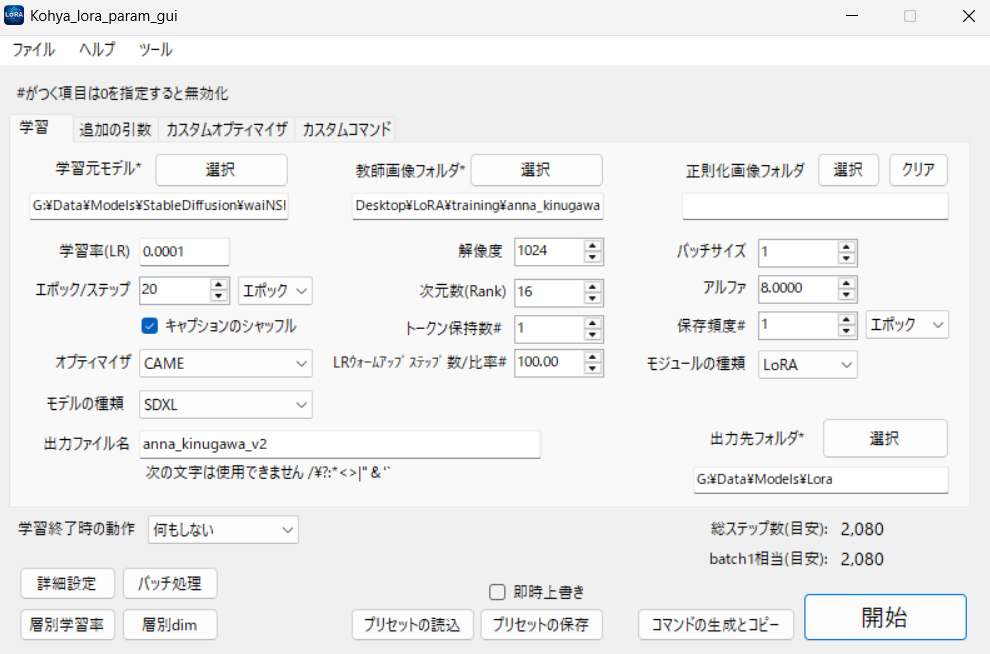
きちんとフォルダ構成ができたら、いつも通り「Kohya lora param gui」で学習していきます。CAMEでの学習の基本は「Illustriousでオリジナルキャラ制作 プロフ作りからLoRA学習まで」の記事で詳しく解説していますので、ここでは学習設定のスクリーンショットを貼るだけにしておきます。(LoRA名がいきなりv2からになってますが、v1はフォルダ指定を間違えて失敗したため、これが実質v1です)
そこまで複雑なキャラクターデザインではないため、dim4/alpha1~dim16/alpha8程度でよいかなと思います。CAMEの場合、ステップ数は2000~3000くらいで学習させることが多いですが、このあたりは各自好みが分かれるところだと思うので、適宜調整してください。
キャプションのシャッフルはON、トークン保持数1にすることで、キャプションの1つ目はトリガーワードとなる「anna_kinugawa」になり、他のタグはランダム化されています。
こちらの設定で学習開始。RTX4080環境で1時間掛からずに完了しました。
【Kohya lora param guiを最新にしたらCAMEでの学習ができなくなった場合】
学習中に出る黒いコマンドプロンプト画面が途中で止まり、(venv) G:\sd-scripts>と表示された場合、モジュール「pytorch_optimizer」のインストールが必要です。最後に表示された(venv) G:\sd-scripts>のあとに、pip install pytorch_optimizerと打ち込みましょう。
(venv) G:\sd-scripts>pip install pytorch_optimizer
のようになっていればOK。ENTERキーをおせばすぐにインストールが済みますので、いったんコマンドプロンプト画面を閉じて、もう一度学習開始してみてください。
生成テスト
というわけで、NovelAI v4の新機能を使うことで、たった1枚の画像から正面・横の立ち絵を含むデータセットを安価に用意し、LoRAを学習することができました。完成した「anna_kinugawa」LoRAで生成テストをしてみます。
XYZ plotを使って、「強度1」「0.75」「0.5」「適用なし(強度0)」で比較生成するとこのようになりました。(Hires・ADetailer使用せず)
プロンプトは「LoRA+1girl,anna_kinugawa,solo, forehead,hair intakes, black hair,flat eyes, (white background, simple background:1.3)+クォリティタグ」です。あえて服装や表情、画角などを指定せず、LoRAの影響を確認しましたが、強度0.5でも十分キャラクターの特徴が出ていますね。
いろいろなプロンプトで生成してみました。ほぼいい感じですね。
・反省ポイントも…
ただ、よく見ると意図通りのLoRAになっていないところが二つあります。特にキャラデザ設定と違う白い瞳孔がたまに出てしまうところと、画角を指定しないとfrom aboveな遠近法ショットになりがちというところです。これは、ひとえにデータセットのチェック不足が原因でした。
データセットをよく見直してみると、「このキャラは紫の瞳に黒い瞳孔にするぞ!」という意識付けが自分の中でしっかりできていなかったため、白い瞳孔の画像がいくつか混入してしまっていました。普段遣いのモデルの画風が白い瞳孔を特徴にしていたため、image2imageした際にプロンプトに反して白い瞳孔に書き換わっていたのですね。(例えば、こちらの画像は片眼だけ白い瞳孔になってしまっています)
また、上から見下ろすショットの画像にちゃんと「from above」タグが付いていなかったのにも気付いていませんでした。この二つのミスのため、「black pupils」と指定しても白い瞳孔が出てしまったり、「anna_kinugawaは上から見下ろされることが多いキャラクターなんだな」と誤認されてしまったりするLoRAができたわけです。
LoRAは必ずデータセットに忠実にできるので、テスト生成でこうしたミスを見つけて直す必要がどうしてもあります。
・ミスを修正しよう
というわけで、ささっと直します。NAI産のデータセットをimage2imageする際に、ADetailerで「black pupils」を強調し、「white pupils」をネガティブに入れます。少しでも白い点が残っていないかよくチェックします(残っていたら手で黒く塗りつぶします)。
タグ付けは、より高性能なタガー「wd-EVA02-Large-v3」でやり直し。画角や構図に関するタグ抜けがないか、入念に目視でチェックします。タガーはモチーフとして描かれたものには敏感ですが、カメラ画角などの「概念」を読み取るのは苦手ですので、きっちり人間が書き足してあげる必要があります。
あとは同じ設定で学習し直し。さきほどと同じ条件で、修正版のLoRAをテストしてみます。
白い瞳孔になる問題は解決したようですね!一方、なんとなく見下ろし構図になってしまうのは依然変わりませんでした。新しいデータセットではfrom aboveタグを徹底しましたが、それとは関係なく、見下ろし構図の枚数が多かったため、構図未指定だとやはりこの構図が出やすくなるようです。(最下段のLoRAなしと見比べると分かる)
とはいえ、これでLoRAは完成。こちらの一枚絵しかなかった状態から…
現在使用しているモデルの画風で、いつでもあんなさんを生成することができるようになりました。
・なぜ、見下ろしで遠近強調の画像ばかり出るのか
これはのちに理解したことですが、原因は「forehead」をタグ付け時に削除したことでした。なぜかというと、実はforeheadは「額を出している髪型」という効果のタグではないからです。実際にforeheadタグで比較生成してみると、それだけで見下ろし・遠近強調の「おでこフォーカス」イラストが生成されがちになることが分かります。foreheadタグには、他の髪型タグと異なり、「おでこ出し+見下ろし+遠近強調」の複合効果があるのです。
illustriousなどのベースモデルで「forehead」とタグ付けされたであろうイラストはどんなものか想像してみます。これはもちろん額を出している髪型の女の子の絵につけるタグではありますが、その中にはおでこを強調した画角が共通して描かれたものが一定数あったのでしょう。そのため、forehead focus+perspective+from aboveのような特徴量が学習されていたものと思われます。
さきほど私はforeheadとタグがつくべきイラストからそのタグを除去してLoRA化したました。そのため、このキャラクターは常にforeheadなキャラクターなのだと強調するLoRAになりました。それが「常に額を出しているキャラ」という意味ならよかったのですが、実際には「常に額を出していて、見下ろし画角で額を強調して描かれることの多いキャラ」という特徴量として学習されてしまったのだと想像されます。あらゆるタグには、そのタグ名から想像される効果以外の付随効果も学習されていますので、除去時には本当に除去してよいものか、それによってどういう効果が生じるかもよく踏まえた上で行う必要がある…という、良い学びになりました。
終わりに - できたLoRAで動画作品を作ろう!
今回このキャラクターのLoRAを作ったのは、Wan2.1とFramePack-eichiを使ってストーリーのあるR-18動画作品を作るためでした。前回はとても載せられない自分用の推しエロパロR-18を自炊してしまったので、同じ手法で今度はオリジナルキャラクターの動画作品を作ってみたい!と思ったのがきっかけです。
二つのツールで一貫性のある動画作品を作るためには、キーフレームとして入力するキャラの各種画像にしっかりとした一貫性がないと始まりません。必ずしもキャラLoRAがないとだめということではありませんが、ポーションとランダムプロンプトを組み合わせれば簡単に作れるなと思いつき、実際に試してみたわけです。結果、再現性と利便性の高い手法がしっかり確立できたと感じています。
今回のLoRAを使って作った動画の導入部分がこちら。
今回作ったようなキャラLoRAがあれば、ポーズがほぼ同じ差分画像もローカルで簡単に作れますので、こうしたキーフレーム作りが非常に楽になります。次回はこのLoRAを使って完成させた動画作品を題材に、各シーンをどのように作って一連の作品にしていったかを記事にまとめたいと思います。
長期目標ではあるのですが、いずれ私の作ったワークフローやプロンプトをそのまま皆さんと共有することで、該当するキーフレームを自分で用意して入れ替えれば、誰でも好きなキャラで同じ動画作品を作れるようになるのではないか?ということを考えています。プレイごとにサンプルワークフローをユーザー間で共有できれば、より簡単に推しのH動画が作れるようになるはずなんですよね。夢は広がるところですが、とりあえず、まずはあんなさんの動画作品をしっかり完成させるところから始めたいと思います。
それでは、今回はこのへんで。スタジオ真榊でした。
Files